سرور GPU سروری است که در کنار پردازنده مرکزی (CPU)، یک یا چند پردازنده گرافیکی (GPU) برای محاسبات موازی دارد. پردازنده مرکزی سیستم‌عامل و منطق برنامه را اداره می‌کند و بخش سنگین و تکراری محاسبه، مثل ضرب ماتریس‌ها در هوش مصنوعی یا محاسبه نور و رنگ پیکسل‌ها در رندر، به GPU سپرده می‌شود. به همین دلیل، کارهایی که ماهیت موازی دارند روی این سرورها زودتر تمام می‌شوند.
✅ آموزش و اجرای مدل‌های بزرگ هوش مصنوعی بدون GPU در مقیاس واقعی بسیار کند است.
✅ رندر سه‌بعدی، پردازش ویدیو و شبیه‌سازی علمی با شتاب‌دهنده گرافیکی زودتر به نتیجه می‌رسد.
✅ انتخاب اشتباه یعنی پرداخت هزینه برای سخت‌افزاری که یا بیکار می‌ماند یا حافظه‌اش کم می‌آید.
✅ در ایران، تهیه پردازنده گرافیکی دیتاسنتری به‌خاطر تحریم محدودیت جدی دارد و باید از ابتدا در برنامه‌ریزی دیده شود.

💡 سرور گرافیکی = سرور + شتاب‌دهنده موازی برای محاسبات سنگین

✅ معیار اصلی انتخاب، ظرفیت و پهنای باند حافظه GPU است، نه فقط تعداد هسته‌ها.
✅ برای بارهای پردازشی وابسته به CPU، سرور اختصاصی HPE وب‌داده با تحویل آنی گزینه آماده‌ای است.
پیش از اجاره یا خرید، باید روشن شود که پروژه واقعاً به پردازنده گرافیکی نیاز دارد یا نه؛ و اگر دارد، کدام کارت و کدام روش تهیه به‌صرفه‌تر است. این راهنما از ساختار سرور گرافیکی شروع می‌کند و بعد به کاربردها، مقایسه کارت‌های رایج دیتاسنتر، روش‌های اجاره و محدودیت‌های تهیه در ایران می‌رسد.

🔶 پردازش سنگین روی سرور اختصاصی ایران

اگر بار کاری‌تان بیشتر به هسته‌های CPU، رم ECC و دیسک NVMe وابسته است، سرور اختصاصی ایران وب‌داده با نصب خودکار سیستم‌عامل، بلافاصله پس از پرداخت تحویل داده می‌شود. اگر پروژه‌تان GPU می‌خواهد، تیم فنی ما گزینه‌های پیکربندی سفارشی و کولوکیشن را با شما بررسی می‌کند 👇

سرور GPU چیست و چه تفاوتی با سرور معمولی دارد؟

از نظر ساختار، سرور گرافیکی همان سرور رک‌مونت یا ایستاده (Tower) است که مادربرد، CPU، رم، دیسک و کارت شبکه دارد. فرقش در شتاب‌دهنده‌هایی است که روی اسلات PCIe یا به‌صورت ماژول SXM نصب می‌شوند. در این ساختار، CPU داده را آماده می‌کند و کار را بین شتاب‌دهنده‌ها تقسیم می‌کند؛ پردازنده گرافیکی محاسبه سنگین را انجام می‌دهد و نتیجه را برمی‌گرداند.
نرم‌افزار برای استفاده از پردازنده گرافیکی به درایور و یک پلتفرم برنامه‌نویسی نیاز دارد. در کارت‌های NVIDIA این لایه CUDA است؛ پلتفرم محاسبات موازی و مدل برنامه‌نویسی خود NVIDIA. در شتاب‌دهنده‌های AMD، همین کار را پلتفرم ROCm انجام می‌دهد. فریم‌ورک‌های یادگیری عمیق و موتورهای رندر روی همین لایه‌ها ساخته شده‌اند؛ پس سازگاری نرم‌افزارتان با یکی از این دو اکوسیستم، اولین شرط انتخاب کارت است.
تفاوت این دو را با یک مثال کارگاهی راحت‌تر می‌شود دید: CPU مثل چند مهندس باتجربه است که کارهای پیچیده و متفاوت را یکی پس از دیگری و با سرعت زیاد انجام می‌دهند. پردازنده گرافیکی مثل خط تولیدی با هزاران کارگر است که همه یک کار ساده را هم‌زمان روی قطعات مختلف تکرار می‌کنند. در ضرب ماتریس‌های بزرگ یا محاسبه رنگ میلیون‌ها پیکسل، خط تولید جلو می‌افتد؛ اما منطق پیچیده یک فروشگاه اینترنتی یا دیتابیس را مهندس‌ها بهتر پیش می‌برند.
Users / Dataset
      ⬇️
[ CPU + RAM ]  OS, scheduling, data prep
      ⬇️  PCIe Gen4 / Gen5  or  SXM + NVLink
[ GPU 1 ] [ GPU 2 ] ...  VRAM / HBM
      ⬇️
Result: model, frame, simulation ✅

📚 آنچه مستندات CUDA می‌گوید

طبق راهنمای برنامه‌نویسی CUDA در مستندات رسمی NVIDIA، CPU طوری طراحی شده که یک رشته (Thread) از دستورها را هرچه سریع‌تر اجرا کند و هم‌زمان فقط چند ده رشته را پیش می‌برد. در مقابل، GPU برای اجرای هم‌زمان هزاران رشته ساخته شده است: سرعت هر رشته کمتر است، اما توان عملیاتی کل بسیار بیشتر می‌شود. به گفته همین منبع، GPU ترانزیستورهای بیشتری را به واحدهای پردازش داده اختصاص می‌دهد و CPU سهم بیشتری را صرف حافظه نهان (Cache) و کنترل جریان برنامه می‌کند.

۱- اجزای اصلی یک سرور گرافیکی

  • پردازنده گرافیکی و حافظه آن: ظرفیت حافظه GPU (از نوع GDDR یا HBM) تعیین می‌کند کدام مدل یا صحنه روی کارت جا می‌شود و پهنای باند آن مشخص می‌کند داده با چه سرعتی به هسته‌ها می‌رسد.
  • پردازنده مرکزی و رم سیستم: بارگذاری مدل، آماده‌سازی داده و مدیریت درخواست کاربران با CPU است و رم سیستم باید برای همه این کارها جای کافی داشته باشد.
  • خطوط PCIe: هر کارت به مسیر ارتباطی کافی نیاز دارد؛ برای نمونه طبق مشخصات Intel ARK، پردازنده Xeon E5-2680 v4 حداکثر ۴۰ خط PCIe 3.0 دارد، اما L4 و L40S برای PCIe Gen4 x16 طراحی شده‌اند و روی پلتفرم نسل ۳ با نیمی از پهنای باند رابط کار می‌کنند.
  • برق و خنک‌سازی: توان مصرفی کارت‌ها از 72W در L4 تا 700W در H100 SXM می‌رسد؛ منبع تغذیه و جریان هوای سرور باید جوابگوی همین عدد باشد.
  • ذخیره‌سازی و شبکه: دیسک NVMe بارگذاری دیتاست و فایل مدل را سریع‌تر می‌کند (مقایسه هارد NVMe و SSD) و در خوشه‌های چندسروری، سرعت شبکه بین سرورها می‌تواند به گلوگاه تبدیل شود.

۲- دو شکل نصب پردازنده گرافیکی؛ PCIe یا SXM

کارت‌های PCIe، مثل L4، L40S و H100 NVL، مانند هر کارت توسعه دیگری در اسلات سرور نصب می‌شوند و با سرورهای رایج دیتاسنتر سازگارند. نسخه SXM ماژولی است که روی برد مخصوص سرورهای چند GPU نصب می‌شود و ارتباط بسیار سریع‌تری بین GPUها فراهم می‌کند. طبق صفحه رسمی NVIDIA، پهنای باند NVLink در H100 SXM به 900GB/s می‌رسد و در H100 NVL، که کارت‌ها با پل NVLink به هم وصل می‌شوند، 600GB/s است.
در عمل، اگر قرار است یک مدل روی یک کارت اجرا شود، نسخه PCIe کافی و در دسترس‌تر است. اما وقتی آموزش یک مدل بزرگ بین چند GPU تقسیم می‌شود، کارت‌ها مدام داده ردوبدل می‌کنند و پهنای باند ارتباط بین آن‌ها به گلوگاه اصلی تبدیل می‌شود. در این حالت، هزینه بیشتر سیستم‌های SXM توجیه پیدا می‌کند.

🔸 نکته فنی: تقسیم یک GPU بین چند کاربر
با قابلیت MIG (Multi-Instance GPU) می‌توان یک پردازنده گرافیکی را به چند بخش ایزوله با حافظه و هسته‌های جداگانه تقسیم کرد. طبق مشخصات رسمی NVIDIA، H100 و H200 از حداکثر ۷ نمونه MIG پشتیبانی می‌کنند، اما L40S این قابلیت را ندارد. اگر می‌خواهید یک کارت را بین چند تیم یا ماشین مجازی تقسیم کنید، این ویژگی را پیش از خرید بررسی کنید.

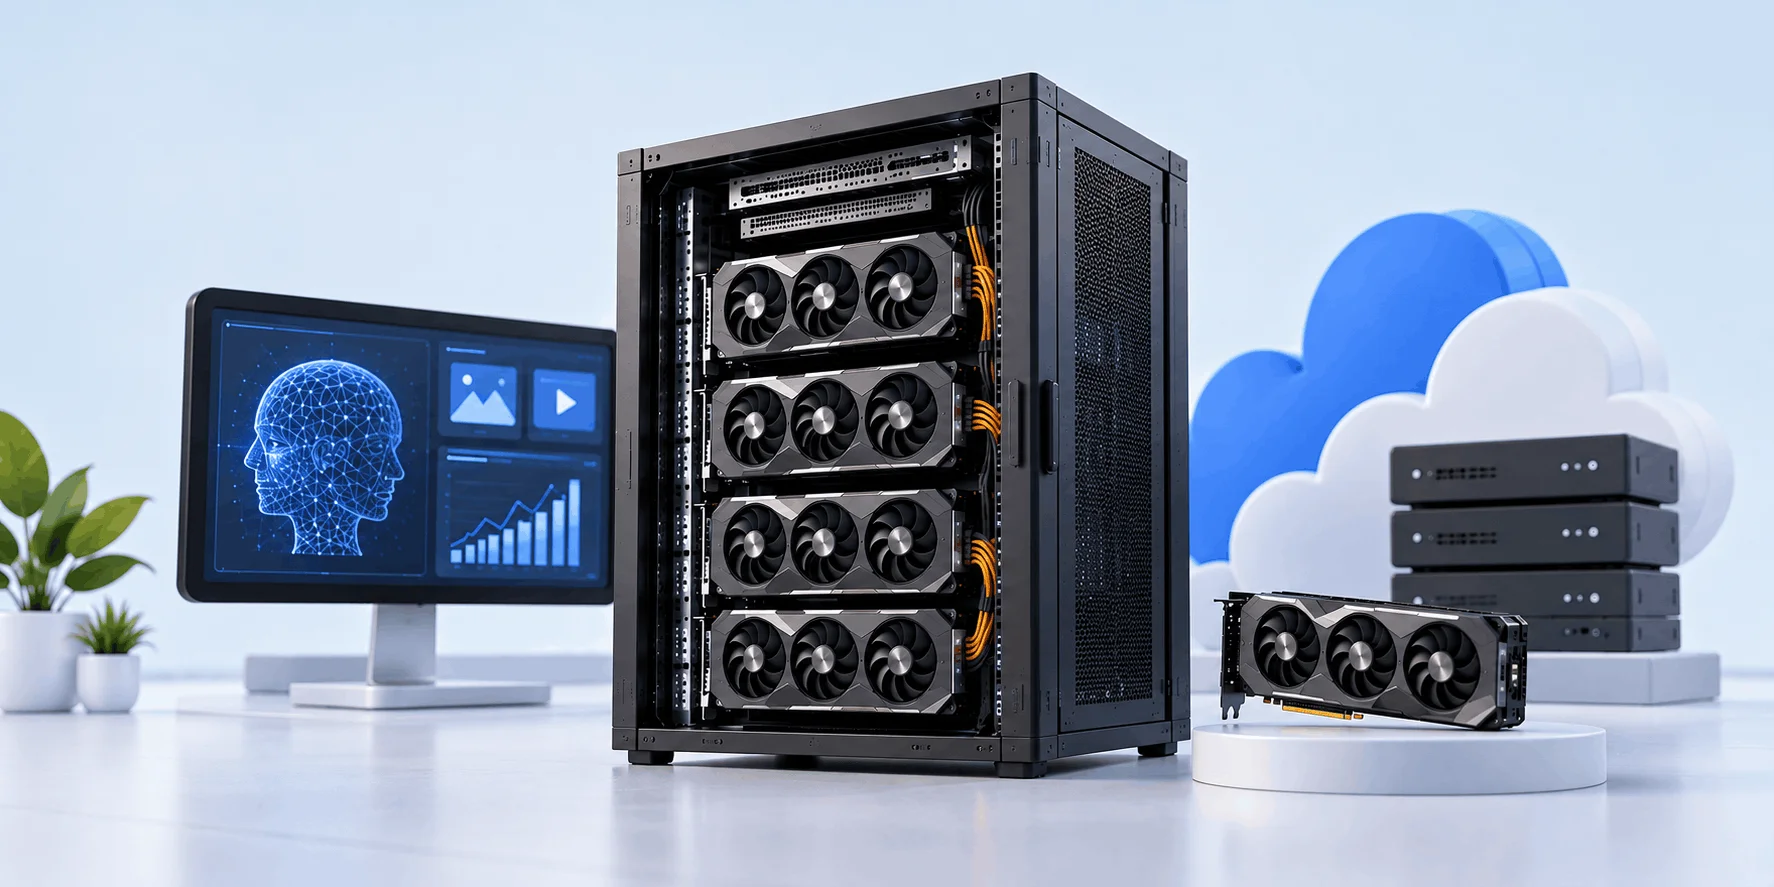
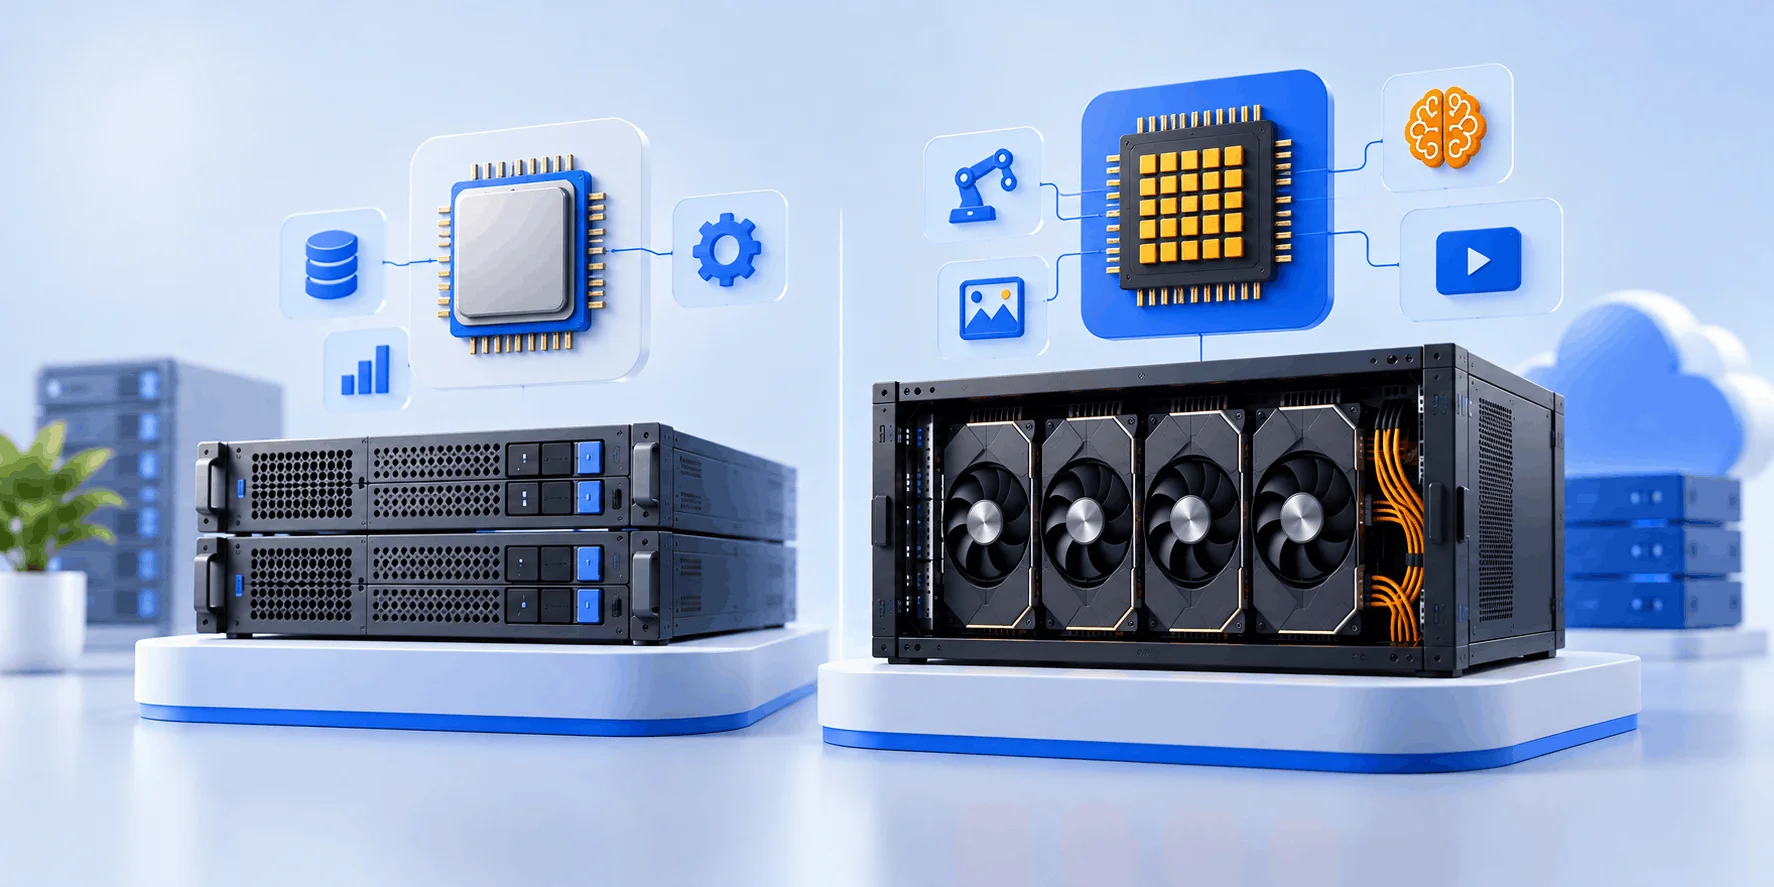
مقایسه سرور معمولی مبتنی بر CPU با سرور GPU دارای چهار کارت گرافیک برای هوش مصنوعی، رندر و ویدیو

مقایسه پردازنده گرافیکی دیتاسنتر؛ از L4 تا H200 و MI300X

جدول زیر مشخصات رسمی چند شتاب‌دهنده رایج دیتاسنتر را از صفحات NVIDIA و AMD Instinct MI300X کنار هم گذاشته است. مشخصات NVIDIA L4 و NVIDIA H200 را هم می‌توانید در صفحه هر محصول ببینید.
مدلحافظه GPUپهنای باند حافظهحداکثر توان و فرم
NVIDIA L424GB300GB/s72W، تک‌اسلاتی PCIe
NVIDIA L40S48GB GDDR6 با ECC864GB/s350W، دواسلاتی PCIe
NVIDIA H100 NVL94GB3.9TB/s350W تا 400W، دواسلاتی PCIe
NVIDIA H100 SXM80GB3.35TB/sتا 700W، SXM
NVIDIA H200 SXM141GB HBM3e4.8TB/sتا 700W، SXM
AMD Instinct MI300X192GB HBM35.3TB/sتا 750W، OAM
فاصله اصلی این کارت‌ها در حافظه، پهنای باند و توان مصرفی است. کارت L4 کم‌مصرف و مناسب استنتاج و پردازش ویدیو است؛ L40S میان هوش مصنوعی و رندر تعادل دارد؛ و H100، H200 و MI300X برای آموزش مدل‌های بزرگ و محاسبات سنگین ساخته شده‌اند. اینکه هر مدل در بازار ایران پیدا می‌شود یا نه، بحث جداگانه‌ای است که در بخش محدودیت‌های تهیه آمده است.

کاربردهای سرور گرافیکی؛ هوش مصنوعی، رندر و پردازش علمی

سرور گرافیکی در همه بارهای کاری به کار نمی‌آید و گاهی فقط هزینه اضافه است. قاعده کلی ساده است: هر جا کار به هزاران عملیات مشابه و مستقل تقسیم شود، شتاب‌دهنده گرافیکی جلو می‌افتد و هر جا منطق برنامه پرشاخه و ترتیبی باشد، CPU انتخاب بهتری است.
✅ توان عملیاتی بالا: هزاران رشته پردازشی هم‌زمان روی داده‌های مختلف اجرا می‌شوند.
✅ پهنای باند حافظه زیاد: داده با سرعتی چند برابر رم سیستم به هسته‌ها می‌رسد.
✅ هسته‌های تخصصی: کارت‌های NVIDIA هسته‌های Tensor برای محاسبات ماتریسی دارند و برخی مدل‌ها، مثل L40S، هسته‌های RT برای ردیابی پرتو در رندر.
✅ چرخه توسعه کوتاه‌تر: هر آزمایش زودتر تمام می‌شود و در همان زمان می‌توان آزمایش‌های بیشتری اجرا کرد.

۱- آموزش و اجرای مدل‌های هوش مصنوعی

در هوش مصنوعی دو کار متفاوت داریم: آموزش (Training)، یعنی مرحله‌ای که مدل از داده یاد می‌گیرد و بیشترین توان و حافظه را می‌خواهد؛ و استنتاج (Inference)، یعنی وقتی مدل آماده به درخواست کاربران پاسخ می‌دهد. برای آشنایی با سخت‌افزار هر مرحله، راهنمای سرور هوش مصنوعی و سخت‌افزار لازم برای مدل‌های AI را ببینید.
حافظه لازم روی پردازنده گرافیکی را می‌توان با یک حساب ساده تخمین زد: در دقت FP16 هر پارامتر دو بایت می‌گیرد. پس مدل ۷ میلیارد پارامتری حدود 14GB فقط برای وزن‌ها لازم دارد و روی L4 با 24GB جا می‌شود. مدل ۷۰ میلیارد پارامتری (70B) در همین دقت حدود 140GB حافظه می‌خواهد که از ظرفیت یک H100 بیشتر است. دو راه دارید: تقسیم مدل بین چند GPU، یا کوانتیزه‌سازی که در دقت ۴ بیتی حجم وزن‌ها را به حدود 35GB می‌رساند. حافظه کاری (KV cache) و سربار فریم‌ورک هم به این عدد اضافه می‌شود.
◀️ برای استنتاج چندکاربره با مدل‌های متوسط، یک کارت PCIe مانند L4 یا L40S معمولاً نقطه شروع منطقی است.
◀️ برای آموزش یا تنظیم دقیق (Fine-tuning) مدل‌های بزرگ، چند GPU با ارتباط NVLink یا معادل آن لازم می‌شود.
◀️ اگر می‌خواهید مدل متن‌باز را روی سرور خودتان اجرا کنید، آموزش راه‌اندازی سرور هوش مصنوعی شخصی با Ollama را دنبال کنید.

۲- رندر سه‌بعدی، انیمیشن و جلوه‌های ویژه

موتورهای رندر مدرن محاسبه نور و سایه را به پردازنده گرافیکی می‌سپارند. طبق مستندات Blender، موتور Cycles روی کارت‌های NVIDIA از CUDA و OptiX پشتیبانی می‌کند و OptiX از سخت‌افزار ردیابی پرتو در کارت‌های RTX استفاده می‌کند. همین مستندات محدودیت اصلی رندر با GPU را حافظه کمتر کارت در صحنه‌های پیچیده می‌داند. وقتی حافظه کارت پر شود، Blender در CUDA و OptiX خودکار سراغ رم سیستم می‌رود که رندر را کندتر می‌کند؛ خطای Out of memory هم معمولاً یعنی حافظه کافی برای نگه‌داشتن صحنه وجود ندارد.
طبق همان مستندات، یک تکسچر 8K حدود 256MB و یک تکسچر 4K حدود 64MB حافظه می‌گیرد؛ پس صحنه معماری با ده‌ها تکسچر باکیفیت به‌سرعت چند گیگابایت از حافظه GPU را پر می‌کند. اگر رندر کار اصلی‌تان است، مقاله سرور رندر برای معماری و انیمیشن جزئیات انتخاب را بررسی کرده است.

۳- پردازش علمی، شبیه‌سازی و تحلیل داده

شبیه‌سازی دینامیک سیالات، مدل‌سازی مولکولی، تحلیل داده‌های حجیم و محاسبات مالی سال‌هاست روی پردازنده گرافیکی اجرا می‌شوند. شرکت AMD هم شتاب‌دهنده MI300X را برای هر دو حوزه هوش مصنوعی مولد و محاسبات علمی معرفی می‌کند. البته همه نرم‌افزارهای علمی نسخه GPU ندارند؛ پیش از خرید مطمئن شوید نرم‌افزارتان از CUDA یا ROCm پشتیبانی می‌کند. برای بارهای پردازشی سنگین بدون GPU، راهنمای سرور محاسباتی (HPC) را بخوانید.

۴- پردازش ویدیو و استریم

بسیاری از کارت‌های دیتاسنتر، از جمله L4 و L40S، موتور سخت‌افزاری کدگذاری و کدگشایی ویدیو (Encode/Decode) دارند. طبق صفحه محصول L4 در سایت NVIDIA، سروری با ۸ کارت L4 تا ۱٬۰۴۰ جریان هم‌زمان AV1 با کیفیت 720p30 را کدگذاری می‌کند. کارت L40S هم سه موتور NVENC و سه موتور NVDEC با پشتیبانی از AV1 دارد. برای سرویس‌های استریم، تبدیل فرمت ویدیو و تحلیل تصاویر دوربین، این موتورها بار سنگینی را از دوش CPU برمی‌دارند.

🎯 سرور گرافیکی مناسب چه کسانی است؟

✅ تیم‌هایی که مدل هوش مصنوعی آموزش می‌دهند یا به کاربران هم‌زمان زیاد پاسخ می‌دهند.
✅ استودیوهای معماری، انیمیشن و جلوه‌های ویژه با صف رندر طولانی.
✅ پژوهشگرانی که نرم‌افزار شبیه‌سازی‌شان از CUDA یا ROCm پشتیبانی می‌کند.
✅ سرویس‌های ویدیویی که تبدیل فرمت و استریم هم‌زمان زیادی دارند.

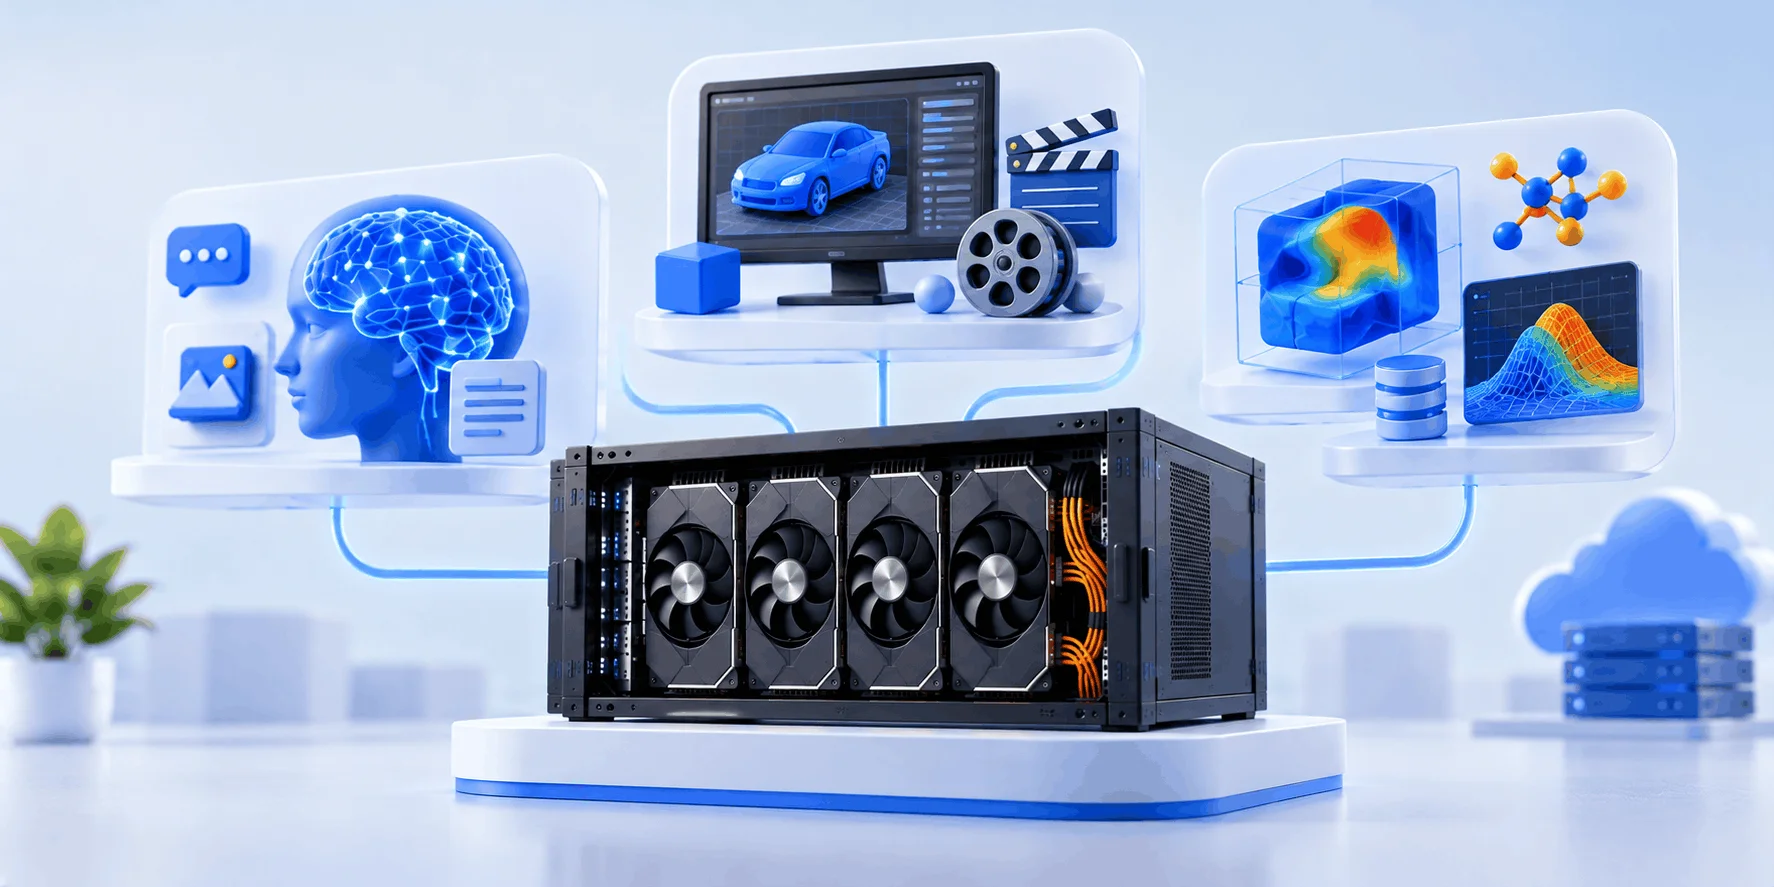
سرور گرافیکی با چهار کارت GPU متصل به کاربردهای هوش مصنوعی، رندر سه‌بعدی و شبیه‌سازی علمی

انتخاب بین GPU و CPU؛ چه زمانی کدام کافی است؟

تفاوت اصلی در پهنای باند حافظه پیداست: هر سوکت Xeon E5-2680 v4 طبق Intel ARK حداکثر 76.8GB/s پهنای باند حافظه دارد، اما این عدد برای L4 برابر 300GB/s و برای H100 SXM برابر 3.35TB/s است. در عوض، سرور دو سوکتی ظرفیت رم بسیار بیشتری دارد و مدل بزرگ را جا می‌دهد، هرچند کندتر اجرا می‌کند.
نوع بار کاریآیا CPU پرهسته کافی است؟چه زمانی GPU لازم است؟
وب‌سایت، دیتابیس و ایمیلبله، گزینه اصلیتقریباً هیچ‌وقت
اجرای مدل زبانی کوچکبله، با کوانتیزه‌سازیبرای کاربران هم‌زمان زیاد
آموزش مدل یادگیری عمیقفقط برای آزمایش‌های کوچکتقریباً همیشه
رندر سه‌بعدیبله، اما کندتربرای صف رندر طولانی و مهلت کوتاه
تبدیل فرمت ویدیوبرای حجم کمبرای استریم هم‌زمان زیاد
مجازی‌سازی و میزبانی VPSبله، گزینه اصلیبرای دسکتاپ مجازی گرافیکی
پس پیش از اجاره GPU، بار کاری واقعی‌تان را اندازه بگیرید. خیلی از کسب‌وکارها برای وب‌سایت، دیتابیس، حسابداری و حتی یک دستیار هوشمند داخلی با CPU پرهسته، رم کافی و دیسک NVMe به نتیجه قابل قبول می‌رسند و سرور گرافیکی را به زمانی موکول می‌کنند که بار کاری واقعاً رشد کرده باشد.

اجاره GPU ساعتی یا ماهانه و محدودیت‌های تهیه در ایران

وقتی مطمئن شدید پروژه به پردازنده گرافیکی نیاز دارد، نوبت انتخاب روش تهیه است. سه مسیر پیش رو دارید: اجاره ساعتی در سرویس ابری، اجاره ماهانه سرور اختصاصی مجهز به GPU و خرید سخت‌افزار و میزبانی آن در دیتاسنتر. هر کدام برای یک الگوی مصرف مناسب است.

۱- اجاره ساعتی GPU در سرویس ابری

در این مدل فقط برای زمان روشن بودن سرور هزینه می‌دهید. برای نمونه، AWS در صفحه قیمت‌گذاری On-Demand اعلام می‌کند هزینه نمونه‌های لینوکس و ویندوز را ثانیه‌ای و با حداقل ۶۰ ثانیه حساب می‌کند. در همین سرویس، نمونه‌های G6 تا ۸ کارت L4 و نمونه‌های P5 تا ۸ کارت H100 دارند. این روش برای آزمایش، آموزش‌های کوتاه و بارهای فصلی مناسب است.
اما این روش دو مانع جدی دارد. مانع اول مخصوص کاربر ایرانی است: ارائه‌دهندگان آمریکایی به دلیل مقررات تحریم (که در ادامه توضیح داده شده) به ساکنان ایران سرویس نمی‌دهند. مانع دوم به الگوی مصرف برمی‌گردد: اگر پردازنده گرافیکی‌تان مدام روشن باشد، مجموع هزینه ساعتی در طول ماه معمولاً از مدل ماهانه بیشتر می‌شود. اگر ارائه‌دهنده‌ای داخلی سرویس اجاره GPU ساعتی عرضه می‌کند، مدل دقیق کارت، حافظه آن و نحوه محاسبه صورت‌حساب را پیش از شروع بپرسید.

۲- اجاره ماهانه سرور اختصاصی گرافیکی

اگر سرویستان ۲۴ ساعته به کاربران پاسخ می‌دهد، مثل چت‌بات سازمانی یا API تشخیص تصویر، اجاره GPU به‌صورت ماهانه هزینه قابل پیش‌بینی‌تری دارد. مزیت‌های این مدل، دسترسی کامل به سیستم‌عامل، آزادی در نصب درایور و فریم‌ورک و، اگر ارائه‌دهنده داخلی باشد، نگهداری داده در داخل کشور است. در عوض باید برای مدت مشخصی متعهد شوید و انتخاب مدل کارت هم محدودتر است. برای مقایسه کلی مدل ابری با سرور اختصاصی، مقاله رایانش ابری و انواع آن را هم مرور کنید.

۳- خرید سرور و میزبانی با کولوکیشن

سازمان‌هایی که بار سنگین و بلندمدت دارند، گاهی سرور گرافیکی را خودشان می‌خرند و در دیتاسنتری با برق پایدار، خنک‌سازی و شبکه مناسب مستقر می‌کنند. در این مدل مالکیت و کنترل کامل با خود سازمان است، اما تأمین قطعه، گارانتی و استهلاک هم به عهده خودش است. برای آشنایی با جزئیات این روش، مقاله کولوکیشن چیست را بخوانید.

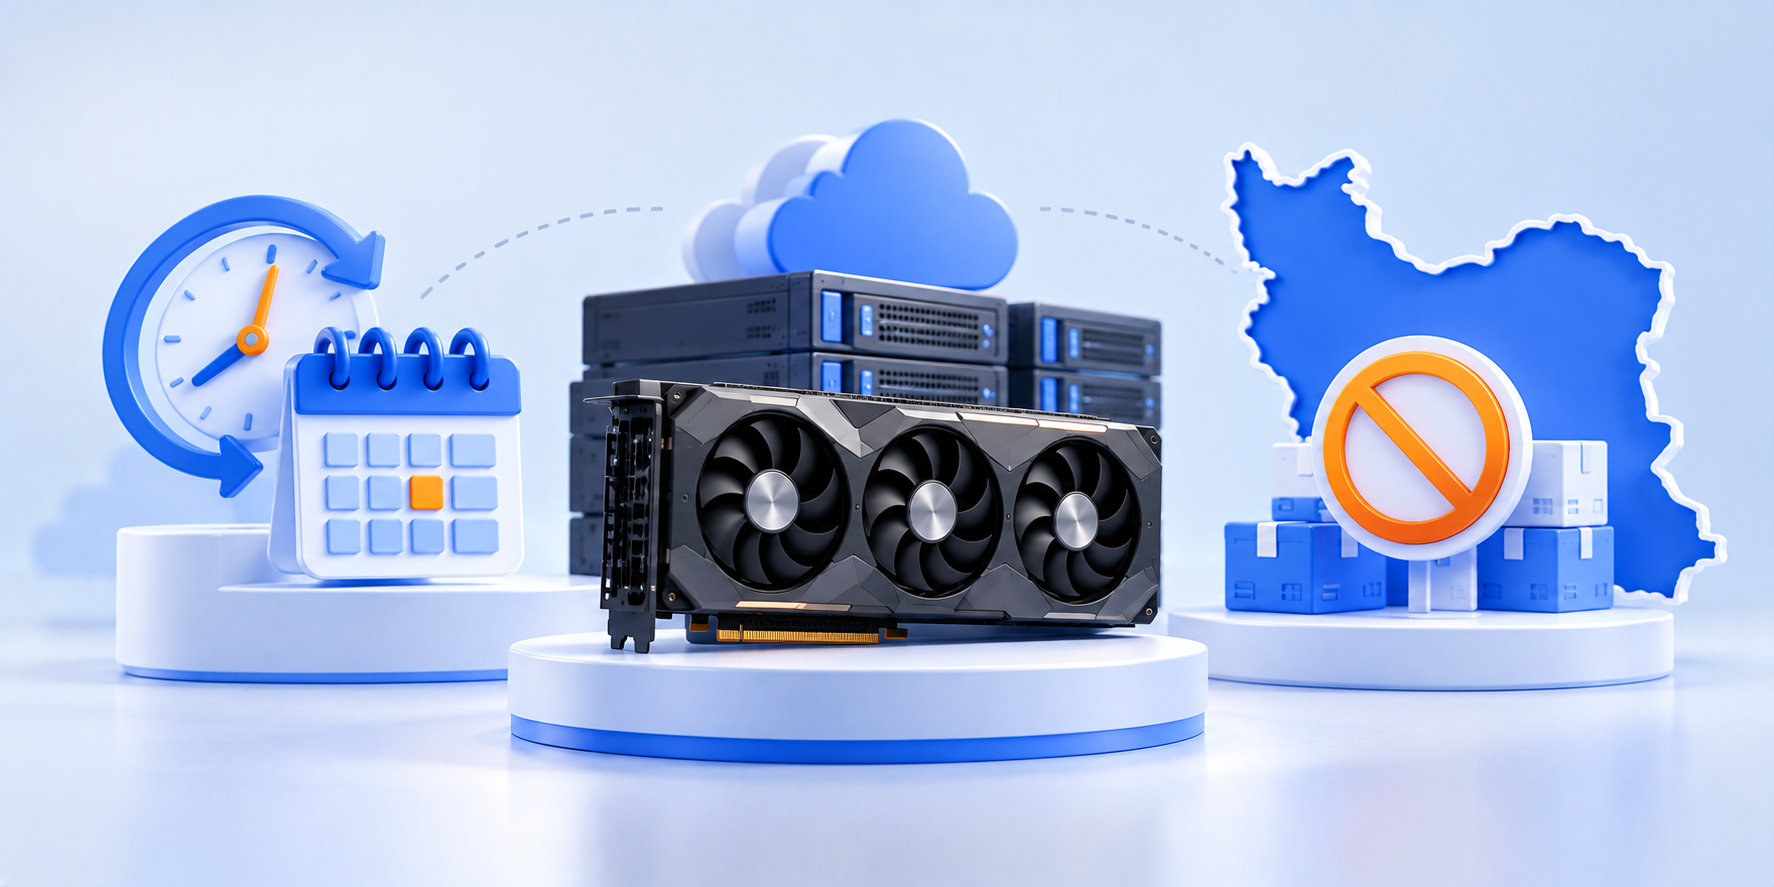
کارت گرافیک و سرور در کنار نماد اجاره ساعتی و ماهانه و نقشه ایران با علامت محدودیت تهیه GPU

مقایسه اجاره GPU ساعتی، ماهانه و خرید

در جدول زیر، سه مسیر تهیه از نظر مدل هزینه، کاربرد مناسب، میزان کنترل سخت‌افزار و ریسک اصلی مقایسه شده‌اند.
معیاراجاره ساعتیاجاره ماهانهخرید و کولوکیشن
مدل هزینهبه ازای زمان مصرفمبلغ ثابت ماهانهسرمایه اولیه و هزینه میزبانی
مناسب برایآزمایش و آموزش کوتاهاستنتاج دائمی ۲۴ ساعتهبار سنگین و بلندمدت
کنترل سخت‌افزارمحدود به نمونه ابریکامل در سطح سیستم‌عاملکامل، حتی انتخاب قطعات
ریسک اصلیهزینه بالا در مصرف دائمیتعهد زمانیتأمین قطعه، گارانتی و استهلاک

محدودیت‌های تهیه پردازنده گرافیکی در ایران

بخش بزرگی از شتاب‌دهنده‌های دیتاسنتر را شرکت‌های آمریکایی مانند NVIDIA و AMD طراحی و عرضه می‌کنند. بند 560.204 از مقررات تحریم ایران در آمریکا (31 CFR Part 560) صادرات، فروش یا عرضه مستقیم و غیرمستقیم هر نوع کالا، فناوری یا خدمات از آمریکا یا توسط اشخاص آمریکایی (در هر کجا) به ایران را ممنوع می‌کند، مگر در مواردی که طبق همین مقررات مجوز داده شده باشد. همین بند، عرضه از طریق کشور ثالث را هم در بر می‌گیرد، اگر عرضه‌کننده بداند یا دلیلی برای دانستن داشته باشد که مقصد نهایی ایران است.
❌ کانال فروش رسمی، گارانتی سازنده و پشتیبانی فنی رسمی برای خریدار داخل ایران در دسترس نیست.
❌ قطعات از بازار واسطه تأمین می‌شوند و اصالت، سابقه کارکرد و قیمت آن‌ها باید با دقت بررسی شود.
❌ حساب‌های ابری خارجی ممکن است به دلیل محل سکونت یا روش پرداخت مسدود شوند و داده در دسترس نباشد.
❌ کارت‌های پرمصرف به برق و خنک‌سازی ویژه نیاز دارند و هر رک یا اتاق سروری آماده آن‌ها نیست.

⚠️ پیش از خرید GPU بدانید

این توضیحات جنبه آگاهی‌بخشی دارد و مشاوره حقوقی نیست. پیش از خرید، مدل دقیق کارت را با شماره سریال و ابزارهای رسمی مثل nvidia-smi بررسی کنید و کارت را زیر بار کامل تست کنید. مصرف برق کل سرور را هم پیش از انتقال به دیتاسنتر با تیم فنی میزبان هماهنگ کنید؛ برای نمونه، سه کارت دواسلاتی L40S به‌تنهایی تا 1050W توان می‌خواهند.

چک‌لیست انتخاب سرور گرافیکی

  1. حافظه پردازنده گرافیکی: مدل یا صحنه شما به‌همراه حافظه کاری باید کامل در حافظه کارت جا شود.
  2. پهنای باند حافظه: در استنتاج مدل‌های زبانی، سرعت تولید پاسخ بیشتر به پهنای باند وابسته است تا تعداد هسته.
  3. سازگاری نرم‌افزار: پشتیبانی نرم‌افزار از CUDA یا ROCm و نسخه درایور لازم را بررسی کنید.
  4. سازگاری سرور میزبان: تعداد اسلات، نسل PCIe، ابعاد کارت و ظرفیت منبع تغذیه را در QuickSpecs سازنده سرور چک کنید.
  5. برق، خنک‌سازی و شبکه: توان کل سرور، جریان هوا و سرعت پورت شبکه را با دیتاسنتر هماهنگ کنید.

یک سناریوی نمونه از مشاوره پیش از خرید

فرض کنید تیمی می‌خواهد برای اسناد داخلی شرکت یک دستیار پرسش‌وپاسخ راه بیندازد و از همان ابتدا سراغ سرور گرافیکی رفته است. بررسی نیاز نشان می‌دهد کاربران هم‌زمان محدودند و یک مدل کوچک کوانتیزه‌شده پاسخ قابل قبولی می‌دهد. در چنین شرایطی، شروع با سرور اختصاصی مبتنی بر CPU و رم کافی منطقی‌تر است. اگر تعداد کاربران یا اندازه مدل بعداً رشد کرد، تیم می‌تواند با داده واقعی مصرف، و نه با حدس، درباره مهاجرت به سرور گرافیکی تصمیم بگیرد.

پردازش سنگین در وب‌داده؛ از سرور CPU محور تا کولوکیشن سرور گرافیکی

شفاف بگوییم: پلن آماده فعلی سرور اختصاصی ایران وب‌داده کارت گرافیک ندارد و برای بارهای CPU محور طراحی شده است. اگر پروژه‌تان در مرحله‌ای است که CPU پرهسته، رم ECC و دیسک NVMe جوابگوی آن است، این پلن بلافاصله پس از پرداخت تحویل داده می‌شود. اگر واقعاً به پردازنده گرافیکی نیاز دارید، مسیرهای پیکربندی سفارشی و کولوکیشن را با هم بررسی می‌کنیم.
✅ سرور HPE DL360 Gen9 با دو پردازنده Xeon E5-2680 v4 (مجموعاً ۲۸ هسته و ۵۶ رشته)
✅ 64GB رم Registered ECC DDR4 و دیسک 1TB NVMe (Samsung 980/990 PRO)
✅ پورت 10Gbit/s روی شبکه‌ای با آپلینک 100Gbit
✅ نصب خودکار سیستم‌عامل و تحویل آنی پس از پرداخت، مستقل از ساعت اداری
✅ محافظت DDoS با ظرفیت 100Gbit/s، فایروال سخت‌افزاری و امنیت چندلایه
✅ بررسی پیکربندی سفارشی مثل رم و فضای بیشتر یا نسل‌های دیگر سرور از طریق تیکت یا تماس
✅ امکان کولوکیشن سرور برای میزبانی سخت‌افزار خودتان؛ برای سرور مجهز به GPU، توان مصرفی و ابعاد را پیش از ارسال با تیم فنی هماهنگ کنید
✅ مشاوره پیش از خرید با تیم فنی ۲۴ ساعته
اگر به نسل جدیدتر فکر می‌کنید، طبق صفحه محصول HPE، سرور ProLiant DL380 Gen11 از PCIe Gen5، تا 8TB رم DDR5 و، بسته به پیکربندی، تا ۸ GPU تک‌عرض یا ۳ GPU دوعرض پشتیبانی می‌کند. مشخصات کامل این نسل را در مقاله سرور HP G11 برای هوش مصنوعی و بار سنگین ببینید؛ اگر چنین پیکربندی‌ای می‌خواهید، از طریق تیکت یا تماس مطرح کنید تا امکان تهیه‌اش بررسی شود.
🚀 بیشتر بدانید: برای اجرای فریم‌ورک‌های هوش مصنوعی و ابزارهای پردازشی در کانتینر، آموزش نصب داکر روی اوبونتو 24.04 نقطه شروع خوبی روی سرور اختصاصی است.

سوالات متداول درباره سرور گرافیکی

سرور GPU با یک کامپیوتر گیمینگ قوی چه فرقی دارد؟

هر دو پردازنده گرافیکی دارند، اما سرور برای کار ۲۴ ساعته طراحی شده است: منبع تغذیه افزونه (Redundant)، مدیریت از راه دور، جریان هوای مناسب رک و پشتیبانی از چند کارت. کارت‌های دیتاسنتر هم معمولاً حافظه بیشتری دارند و در مدل‌هایی مانند L40S حافظه با ECC ارائه می‌شود. برای آزمایش شخصی، کامپیوتر گیمینگ اغلب کافی است؛ برای سرویسی که شبانه‌روز به کاربران پاسخ می‌دهد، سرور انتخاب مطمئن‌تری است.

بله، برای استنتاج مدل‌های کوچک و کوانتیزه‌شده، ابزارهایی مانند llama.cpp و Ollama روی CPU هم کار می‌کنند. محدودیت اصلی، سرعت تولید پاسخ است؛ چون پهنای باند رم سیستم بسیار کمتر از حافظه GPU است. برای چند کاربر هم‌زمان یا ابزار داخلی سازمان، سرور CPU پرهسته با رم کافی شروع خوبی است؛ اما آموزش مدل‌های بزرگ بدون GPU عملاً مقرون‌به‌صرفه نیست.

برای آزمایش مدل‌های مختلف، آموزش‌های کوتاه، رندر یک پروژه با مهلت مشخص و بارهای فصلی. در این حالت فقط برای ساعات استفاده هزینه می‌دهید. اما اگر GPU بیشتر روزهای ماه روشن است، مدل ماهانه معمولاً اقتصادی‌تر است. از ایران هم دسترسی به سرویس‌های ابری آمریکایی به دلیل تحریم عملاً ممکن نیست و باید سراغ ارائه‌دهنده‌ای رفت که بتواند به‌طور قانونی به کاربر ساکن ایران سرویس بدهد.

عدد ثابتی وجود ندارد و همه‌چیز به صحنه بستگی دارد. طبق مستندات Blender، یک تکسچر 8K حدود 256MB حافظه می‌گیرد؛ پس صحنه‌ای با تکسچرهای زیاد به‌سرعت چند گیگابایت را پر می‌کند. مطمئن‌ترین روش، رندر آزمایشی صحنه واقعی و دیدن مصرف حافظه است. اگر صحنه در حافظه کارت جا نشود، Blender در CUDA و OptiX سراغ رم سیستم می‌رود و رندر کند می‌شود؛ اگر حافظه کافی پیدا نکند، خطای Out of memory می‌دهد.

بستگی به کار دارد. کارت L40S با 48GB حافظه، هسته‌های RT و توان 350W گزینه‌ای متعادل برای استنتاج، رندر و گرافیک است. کارت H100 با حافظه HBM و پهنای باند چند برابر برای آموزش مدل‌های بزرگ ساخته شده و از MIG پشتیبانی می‌کند، اما بسیار گران‌تر است و نسخه SXM آن تا 700W مصرف دارد. برای رندر معمولاً L40S منطقی‌تر است و برای آموزش سنگین، H100.

پلن آماده فعلی سرور اختصاصی ایران وب‌داده GPU ندارد و برای بارهای CPU محور طراحی شده است. اگر به پردازنده گرافیکی نیاز دارید، موضوع را از طریق تیکت یا تماس مطرح کنید تا امکان پیکربندی سفارشی بررسی شود. اگر سرور گرافیکی خودتان را دارید، می‌توانید آن را با سرویس کولوکیشن در دیتاسنتر میزبانی کنید.

بله. در کارت‌هایی که از MIG پشتیبانی می‌کنند، مثل H100 و H200، می‌توان یک GPU را به حداکثر ۷ بخش ایزوله تقسیم کرد. راه دیگر، اختصاص کامل یک کارت به یک ماشین مجازی با PCI Passthrough است. کارت L40S از MIG پشتیبانی نمی‌کند، اما طبق صفحه محصول NVIDIA با نرم‌افزار vGPU، که لایسنس جداگانه دارد، بین چند ماشین مجازی تقسیم می‌شود. پس اگر تقسیم کارت برایتان مهم است، روش تقسیم و هزینه لایسنس را پیش از خرید بررسی کنید. مبانی این موضوع را در مقاله مجازی‌سازی چیست بخوانید.

به دلیل مقررات تحریم آمریکا، خرید از کانال رسمی، گارانتی سازنده و پشتیبانی رسمی در دسترس نیست و قطعات از بازار واسطه تأمین می‌شوند. به همین دلیل، اصالت و سابقه کارکرد کارت را بررسی کنید و سلامتش را با تست زیر بار کامل بسنجید. کارت‌های پرمصرف هم به برق و خنک‌سازی مناسب دیتاسنتر نیاز دارند. در کنار هزینه خرید، هزینه جایگزینی قطعه معیوب را هم در نظر بگیرید.

جمع‌بندی؛ GPU را برای کار درست انتخاب کنید

سرور GPU در اصل یک سرور کامل است که کار سنگین و موازی آن را شتاب‌دهنده‌های گرافیکی انجام می‌دهند. معیار اصلی مقایسه کارت‌ها، از L4 تا H200 و MI300X، حافظه، پهنای باند و توان مصرفی است و بیشترین کاربردشان در هوش مصنوعی، رندر، پردازش علمی و ویدیو است.
انتخاب با بار کاری شروع می‌شود، نه با نام کارت. اگر کارتان ماهیت موازی دارد، مثل آموزش مدل، رندر سنگین یا پاسخ به کاربران هم‌زمان زیاد، پردازنده گرافیکی ارزش هزینه‌اش را دارد؛ فقط کارتی انتخاب کنید که مدل یا صحنه در حافظه‌اش جا شود. در غیر این صورت، سرور CPU پرهسته با رم کافی نقطه شروع کم‌ریسک‌تری است. در انتخاب بین اجاره ساعتی، ماهانه یا خرید هم الگوی مصرف و محدودیت‌های تهیه در ایران را جدی بگیرید.
اگر نقطه شروعتان سرور مبتنی بر CPU است، سرور اختصاصی HPE وب‌داده با تحویل آنی و محافظت DDoS آماده است و برای سخت‌افزار گرافیکی خودتان هم سرویس کولوکیشن داریم. تیم فنی ۲۴ ساعته ما پیش از خرید به پرسش‌هایتان پاسخ می‌دهد. توصیه پایانی: نیاز واقعی را اندازه بگیرید و ارتقا را به زمانی بسپارید که داده مصرف آن را لازم نشان دهد.
اگر درباره انتخاب سرور گرافیکی یا جایگزین مبتنی بر CPU آن سوالی دارید، در بخش نظرات بپرسید؛ تیم فنی وب‌داده پاسخ می‌دهد.
وب داده
وب داده

جدید ترین مطالب آموزشی و کاربردی را در اینجا بخوانید !
ما با بهره‌گیری از دانش روز و تجربه متخصصان حوزه فناوری، مجموعه‌ای از آموزش‌های کاربردی و مقالات تخصصی را گردآوری کرده‌ایم که هر یک، پاسخی دقیق به پرسش‌های شماست. ؛ از مفاهیم پایه تا پیچیده‌ترین تکنیک‌های حرفه‌ای. اینجا، دانش با زبانی ساده اما عمیق در اختیار شما قرار می‌گیرد.

مقاله‌ها: 227
پاسخی بگذارید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *