سرور و دیتاسنتر | بلاگ وب‌داده

سرور محاسباتی (HPC) چیست و کی واقعاً به پردازش سنگین نیاز دارید؟

از پردازش موازی و قانون امدال تا انتخاب پردازنده، رم، شبکه و زمان‌بند Slurm؛ هر آنچه یک تیم پژوهشی یا مهندسی پیش از اجاره سرور برای شبیه‌سازی و تحلیل عددی باید بداند.

💡 خلاصه مقاله در ۳ خط

✅ سرور HPC ماشینی پرهسته یا مجموعه‌ای از چند سرور است که یک مسئله بزرگ علمی یا مهندسی را به بخش‌های کوچک می‌شکند و هم‌زمان پردازش می‌کند.
✅ پیش از انتخاب، گلوگاه بار خود را بشناسید: هسته، پهنای باند حافظه، شبکه یا GPU؛ چون طبق قانون امدال، هسته بیشتر همیشه سرعت بیشتر نمی‌آورد.
✅ برای بسیاری از پروژه‌های دانشگاهی، یک سرور پردازشی دوپردازنده‌ای با رم ECC و دیسک NVMe شروع منطقی است و کلاستر چندگره‌ای برای مقیاس بزرگ‌تر می‌ماند.
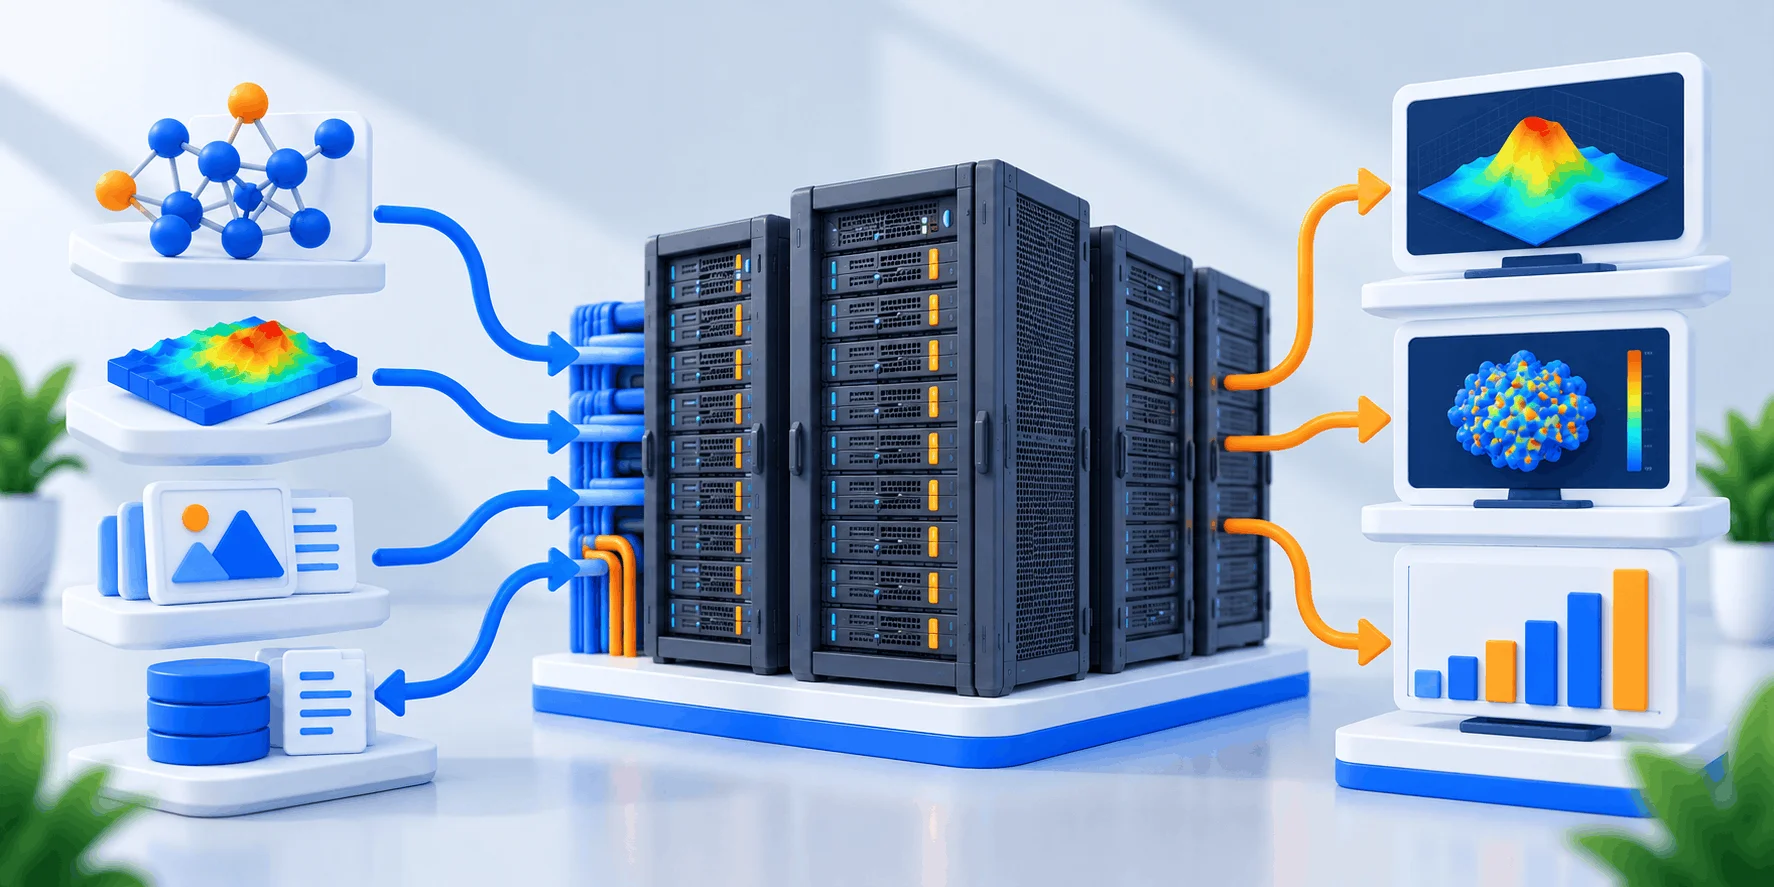
سرور محاسباتی (Compute Server) یا سرور HPC، سروری است که برای «محاسبات با کارایی بالا» (High-Performance Computing) پیکربندی می‌شود. هدف HPC اجرای محاسبات عددی سنگین مثل شبیه‌سازی جریان سیال، دینامیک مولکولی یا مدل‌های آب‌وهوایی در کوتاه‌ترین زمان ممکن است. این سرورها برای پاسخ دادن به هزاران بازدیدکننده ساخته نشده‌اند؛ کارشان تمام کردن یک محاسبه بزرگ به کمک پردازش موازی است. در مقیاس بزرگ، ده‌ها یا صدها سرور با شبکه‌ای پرسرعت به هم وصل می‌شوند و یک کلاستر HPC می‌سازند.
  • کوتاه کردن زمان اجرای شبیه‌سازی‌هایی که روی کامپیوتر شخصی روزها طول می‌کشند
  • اجرای مدل‌هایی که به رمی بیش از ظرفیت یک کامپیوتر معمولی نیاز دارند
  • اجرای هم‌زمان ده‌ها سناریو یا پارامتر مختلف برای تحلیل حساسیت
  • آزاد ماندن سیستم شخصی پژوهشگر و اجرای شبانه‌روزی جاب‌ها بدون وقفه

💡 سرور HPC = تقسیم یک محاسبه بزرگ بین هسته‌های زیاد

✅ در بارهای موازی، تعداد هسته، پهنای باند حافظه و سرعت شبکه از فرکانس تک‌هسته مهم‌ترند.
✅ سرور اختصاصی HPE با 56 رشته پردازشی و رم ECC برای شروع پروژه‌های پژوهشی، تنها در وب‌داده
حتماً زمانی که این مقاله را باز کرده‌اید، به دنبال این هستید که بفهمید شبیه‌سازی یا تحلیل عددی شما واقعاً به سرور پردازشی نیاز دارد یا نه و اگر دارد، چه سخت‌افزاری باید بخرید یا اجاره کنید. در ادامه گام‌به‌گام می‌بینیم HPC چطور کار می‌کند، کجا کاربرد دارد، چه سخت‌افزار و نرم‌افزاری می‌خواهد و اجاره آن برای دانشگاه‌ها چه نکاتی دارد؛ پس همراه ما باشید 😉👇

🔶 سرور اختصاصی ایران برای پردازش‌های پژوهشی

پلن آماده سرور اختصاصی ایران وب‌داده با 56 رشته پردازشی، 64GB رم ECC و دیسک NVMe پس از پرداخت تحویل آنی دارد. این پلن GPU و InfiniBand ندارد؛ نیازهای خاص را از طریق تیکت یا تماس مطرح کنید 👇

سرور محاسباتی چیست و چطور کار می‌کند؟

برای درک HPC یک پروژه ساختمانی را تصور کنید. یک استادکار ماهر به‌تنهایی هم می‌تواند ساختمان را بسازد، اما کار سال‌ها طول می‌کشد. اگر همان کار بین صد نفر تقسیم شود و یک سرپرست آن را هماهنگ کند، ساختمان در چند ماه آماده می‌شود. سرور HPC همین کار را با محاسبات انجام می‌دهد: مسئله بزرگ به تکه‌های کوچک شکسته می‌شود، هر هسته پردازنده یک تکه را حل می‌کند و نتایج در پایان کنار هم قرار می‌گیرند.
آزمایشگاه ملی لارنس لیورمور (LLNL) در آموزش رسمی خود، محاسبات موازی را استفاده هم‌زمان از چند منبع محاسباتی برای حل یک مسئله تعریف می‌کند. همین ایده پشت همه ابررایانه‌ها و کلاسترهای دانشگاهی قرار دارد. فرقی نمی‌کند یک سرور دوپردازنده‌ای داشته باشید یا هزار گره؛ اصل کار همان پردازش موازی است و تفاوت فقط در مقیاس و شیوه ارتباط اجزاست.

اجزای یک کلاستر HPC طبق معماری مرجع NIST

مؤسسه ملی استاندارد و فناوری آمریکا (NIST) در سند SP 800-223 که فوریه 2024 منتشر شد، برای سامانه‌های HPC یک معماری مرجع با چهار ناحیه کارکردی معرفی می‌کند. شناختن این اجزا کمک می‌کند بدانید در یک سرور تکی، کدام نقش‌ها روی همان ماشین جمع می‌شوند:
  1. ناحیه دسترسی (Access Zone): گره‌های ورود (Login Node) که به شبکه بیرونی وصل‌اند و احراز هویت و مجوزدهی کاربران را انجام می‌دهند.
  2. ناحیه محاسبه (HPC Zone): مجموعه‌ای از گره‌های محاسباتی که با یک یا چند شبکه پرسرعت به هم متصل‌اند و جاب‌های موازی را در مقیاس بالا اجرا می‌کنند.
  3. ناحیه ذخیره‌سازی داده: یک یا چند فایل‌سیستم موازی پرسرعت برای نگهداری داده‌های حجیم و خواندن و نوشتن سریع آن‌ها.
  4. ناحیه مدیریت: گره‌هایی که مدیران سامانه از طریق آن‌ها زیرساخت را پیکربندی، پایش و نگهداری می‌کنند.
User (SSH)
     ⬇️
[ Login Node ] ➡️ [ Scheduler: Slurm ]
                        ⬇️
[ Node 1 ] ⬅️ Interconnect ➡️ [ Node 2 ... N ]
     ⬇️                              ⬇️
[    Parallel File System / NVMe Scratch    ]
در یک سرور پردازشی تکی، همه این نقش‌ها روی یک ماشین جمع می‌شوند: همان سروری که با SSH به آن وصل می‌شوید، محاسبه را انجام می‌دهد و داده‌ها را روی دیسک NVMe محلی نگه می‌دارد. به همین دلیل شروع کار با یک سرور ساده‌تر است و به مدیریت کمتری نیاز دارد.

🔸 نگاهی به فهرست TOP500 در 2026

در شصت‌وهفتمین فهرست TOP500 که ژوئن 2026 منتشر شد، سامانه LineShine در مرکز ملی ابررایانه شنژن چین با 2.198 اگزافلاپس در آزمون HPL رتبه اول را گرفت. El Capitan و Frontier در آمریکا رتبه‌های دوم و سوم را دارند و اکنون پنج سامانه در رده اگزااسکیل، یعنی دست‌کم 1018 عملیات ممیز شناور در ثانیه، قرار دارند.

پردازش موازی؛ حافظه مشترک یا حافظه توزیع‌شده؟

برنامه‌های HPC معمولاً به یکی از دو روش موازی می‌شوند. در مدل حافظه مشترک، همه رشته‌ها (Thread) به یک رم دسترسی دارند؛ این همان وضعیت داخل یک سرور است و استاندارد OpenMP برای آن ساخته شده است. آخرین نسخه این استاندارد، OpenMP 6.0، در نوامبر 2024 منتشر شد.
در مدل حافظه توزیع‌شده، هر پردازه (Process) رم خودش را دارد و داده‌ها با ارسال پیام جابه‌جا می‌شوند. استاندارد این روش MPI است که نسخه 5.0 آن در ژوئن 2025 در انجمن MPI تصویب شد. بیشتر نرم‌افزارهای جدی مهندسی ترکیبی از هر دو را به کار می‌برند: MPI بین سرورها و OpenMP داخل هر سرور. خبر خوب اینکه برنامه MPI روی یک سرور تکی هم اجرا می‌شود و بعدها معمولاً بدون تغییر در کد، روی کلاستر هم قابل اجراست.

قانون امدال؛ چرا هسته بیشتر همیشه سریع‌تر نیست

تقریباً هر برنامه بخشی دارد که فقط به‌صورت ترتیبی اجرا می‌شود؛ مثل خواندن ورودی یا جمع کردن نتایج. قانون امدال می‌گوید همین بخش ترتیبی سقف سرعت پردازش موازی را تعیین می‌کند. اگر P سهم بخش موازی، S سهم بخش ترتیبی و N تعداد پردازنده‌ها باشد، شتاب (Speedup) از رابطه زیر به دست می‌آید:
Speedup = 1 / (S + P / N)

P = 0.95 , N = 10     ➡️  ~6.9x
P = 0.95 , N = 10000  ➡️  ~20x (ceiling)
طبق مثال LLNL، حتی اگر ۹۵ درصد برنامه موازی باشد، با ده هزار پردازنده هم شتاب از حدود ۲۰ برابر بالاتر نمی‌رود. نتیجه عملی روشن است: پیش از اجاره سرور بزرگ‌تر، مقیاس‌پذیری نرم‌افزار خودتان را با ۱، ۲، ۴، ۸ هسته و بیشتر آزمایش کنید و نقطه‌ای را پیدا کنید که افزودن هسته دیگر سود چندانی ندارد.

سرور محاسباتی چیست و چطور کار می‌کند؟

مقایسه سرور پردازشی تکی، کلاستر HPC و سرور GPU

برای پردازش سنگین سه مسیر رایج وجود دارد. جدول زیر تفاوت آن‌ها را از نگاه یک تیم پژوهشی خلاصه می‌کند:
معیارسرور پردازشی تکیکلاستر HPCسرور GPU
ساختاریک سرور دوپردازنده‌ای پرهستهده‌ها تا هزاران گره با شبکه سریعسرور با یک یا چند کارت شتاب‌دهنده
مدل برنامه‌نویسیOpenMP یا MPI روی یک گرهMPI بین گره‌ها و OpenMP داخل گرهCUDA، ROCm یا کتابخانه‌های آماده
شبکه میان‌گره‌ایلازم نیستInfiniBand یا اترنت کم‌تأخیربسته به تعداد گره
مناسب برایCFD و FEA متوسط، جاب‌های پارامتریمدل‌های بسیار بزرگ و پروژه‌های ملییادگیری عمیق و نرم‌افزارهای شتاب‌یافته
پیچیدگی راه‌اندازیکمزیاد (زمان‌بند، فایل‌سیستم موازی، شبکه)متوسط (درایور و نسخه CUDA)

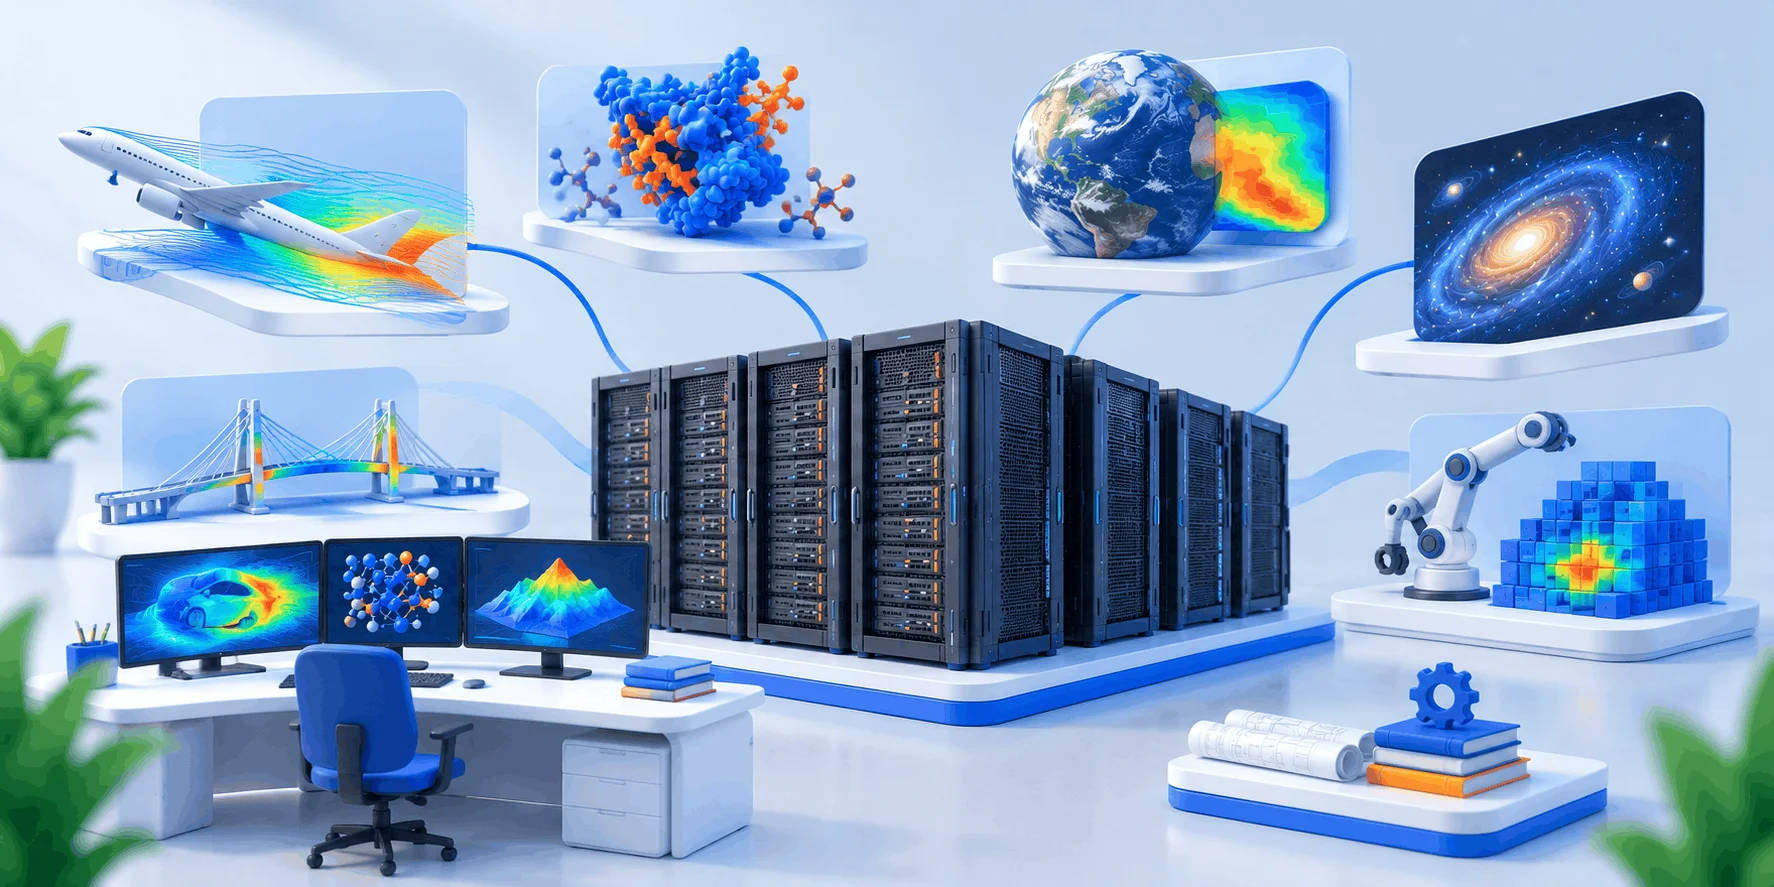
کاربردهای سرور HPC در مهندسی و پژوهش؛ کی به پردازش سنگین نیاز دارید؟

سرور HPC ابزار مشترک رشته‌هایی است که با مدل‌سازی عددی سروکار دارند. در ادامه مهم‌ترین کاربردها را همراه با نرم‌افزارهای شاخص هر حوزه می‌بینید:
✅ دینامیک سیالات محاسباتی (CFD): شبیه‌سازی جریان هوا روی بال، خنک‌کاری تجهیزات یا تهویه ساختمان با نرم‌افزارهایی مثل OpenFOAM و ANSYS Fluent.
✅ تحلیل اجزای محدود (FEA): بررسی تنش، ارتعاش و خستگی سازه‌ها و قطعات در مهندسی عمران و مکانیک.
✅ دینامیک مولکولی و شیمی محاسباتی: شبیه‌سازی رفتار پروتئین‌ها و مولکول‌های دارویی با GROMACS یا محاسبات کوانتومی مولکول‌ها.
✅ هواشناسی و اقلیم: اجرای مدل‌های عددی پیش‌بینی وضع هوا و سناریوهای تغییر اقلیم با شبکه‌بندی بسیار ریز.
✅ بیوانفورماتیک: هم‌ترازی توالی‌های ژنوم و تحلیل داده‌های توالی‌یابی که هر نمونه در آن مستقل پردازش می‌شود.
✅ مالی و مدیریت ریسک: شبیه‌سازی مونت‌کارلو برای ارزش‌گذاری سبد دارایی و آزمون سناریوهای بحران.
✅ هوش مصنوعی: آموزش و اجرای مدل‌ها؛ این حوزه را در راهنمای سرور هوش مصنوعی و سخت‌افزار لازم برای مدل‌های AI جداگانه بررسی کرده‌ایم.
همه این بارها یک شکل ندارند. بعضی از آن‌ها در دسته Embarrassingly Parallel یا «موازی‌پذیر آسان» قرار می‌گیرند؛ LLNL این دسته را مسائلی می‌داند که تقریباً هیچ هماهنگی میان وظایف لازم ندارند، مثل پردازش جداگانه هزاران نمونه ژنوم یا اجرای یک مدل با صدها پارامتر متفاوت. دسته دیگر، مثل CFD، مدام بین هسته‌ها داده رد و بدل می‌کنند و به حافظه و شبکه سریع حساس‌اند.
رندر سه‌بعدی هم نمونه‌ای از بار کاملاً موازی است، چون هر فریم مستقل ساخته می‌شود. جزئیات سخت‌افزار و نرم‌افزار آن را در مقاله سرور رندر برای معماری و انیمیشن ببینید.

نشانه‌هایی که می‌گویند به سرور پردازشی نیاز دارید

◀️ اجرای هر شبیه‌سازی روی کامپیوتر شخصی بیش از یک شب طول می‌کشد و چرخه آزمون و خطا را کند کرده است.
◀️ مدل شما به دلیل کمبود رم اجرا نمی‌شود یا سیستم‌عامل مدام از فضای Swap استفاده می‌کند.
◀️ باید ده‌ها یا صدها سناریو را اجرا کنید و صف انتظار کلاستر مشترک دانشگاه، زمان‌بندی پروژه را به هم ریخته است.
◀️ نرم‌افزار شما از MPI یا OpenMP پشتیبانی می‌کند و در آزمون‌های اولیه با افزایش هسته سریع‌تر شده است.
◀️ داده‌های پژوهش حساس‌اند و ترجیح می‌دهید روی سروری پردازش شود که فقط در اختیار تیم شماست.

چه زمانی HPC لازم نیست؟

❌ نرم‌افزار شما فقط از یک هسته استفاده می‌کند؛ در این حالت پردازنده‌ای با فرکانس بالاتر از سرور پرهسته مفیدتر است.
❌ هر محاسبه چند دقیقه طول می‌کشد و فقط گاهی تکرار می‌شود.
❌ بار اصلی شما آموزش شبکه‌های عصبی بزرگ است که به سرور GPU و پردازنده گرافیکی نیاز دارد، نه صرفاً هسته‌های بیشتر CPU.
❌ لایسنس نرم‌افزار تجاری شما بر اساس تعداد هسته است و هزینه لایسنس هسته‌های اضافه از صرفه‌جویی زمانی آن بیشتر می‌شود.

📚 از منابع معتبر

NIST در سند SP 800-223 یادآوری می‌کند که سامانه‌های HPC از نظر طراحی، برنامه‌هایی که اجرا می‌کنند و مأموریتی که دارند با هم متفاوت‌اند؛ به همین دلیل، این سند یک معماری مرجع و واژگان مشترک پیشنهاد می‌کند تا بحث امنیت HPC بر پایه‌ای یکسان انجام شود. برداشت عملی ما برای یک سرور پژوهشی ساده است: دسترسی کاربران را کنترل‌شده نگه دارید و فقط سرویس‌های لازم را روی اینترنت باز بگذارید.

کاربردهای سرور HPC در مهندسی و پژوهش؛ کی به پردازش سنگین نیاز دارید؟

سخت‌افزار مناسب سرور HPC و راه‌اندازی گام‌به‌گام

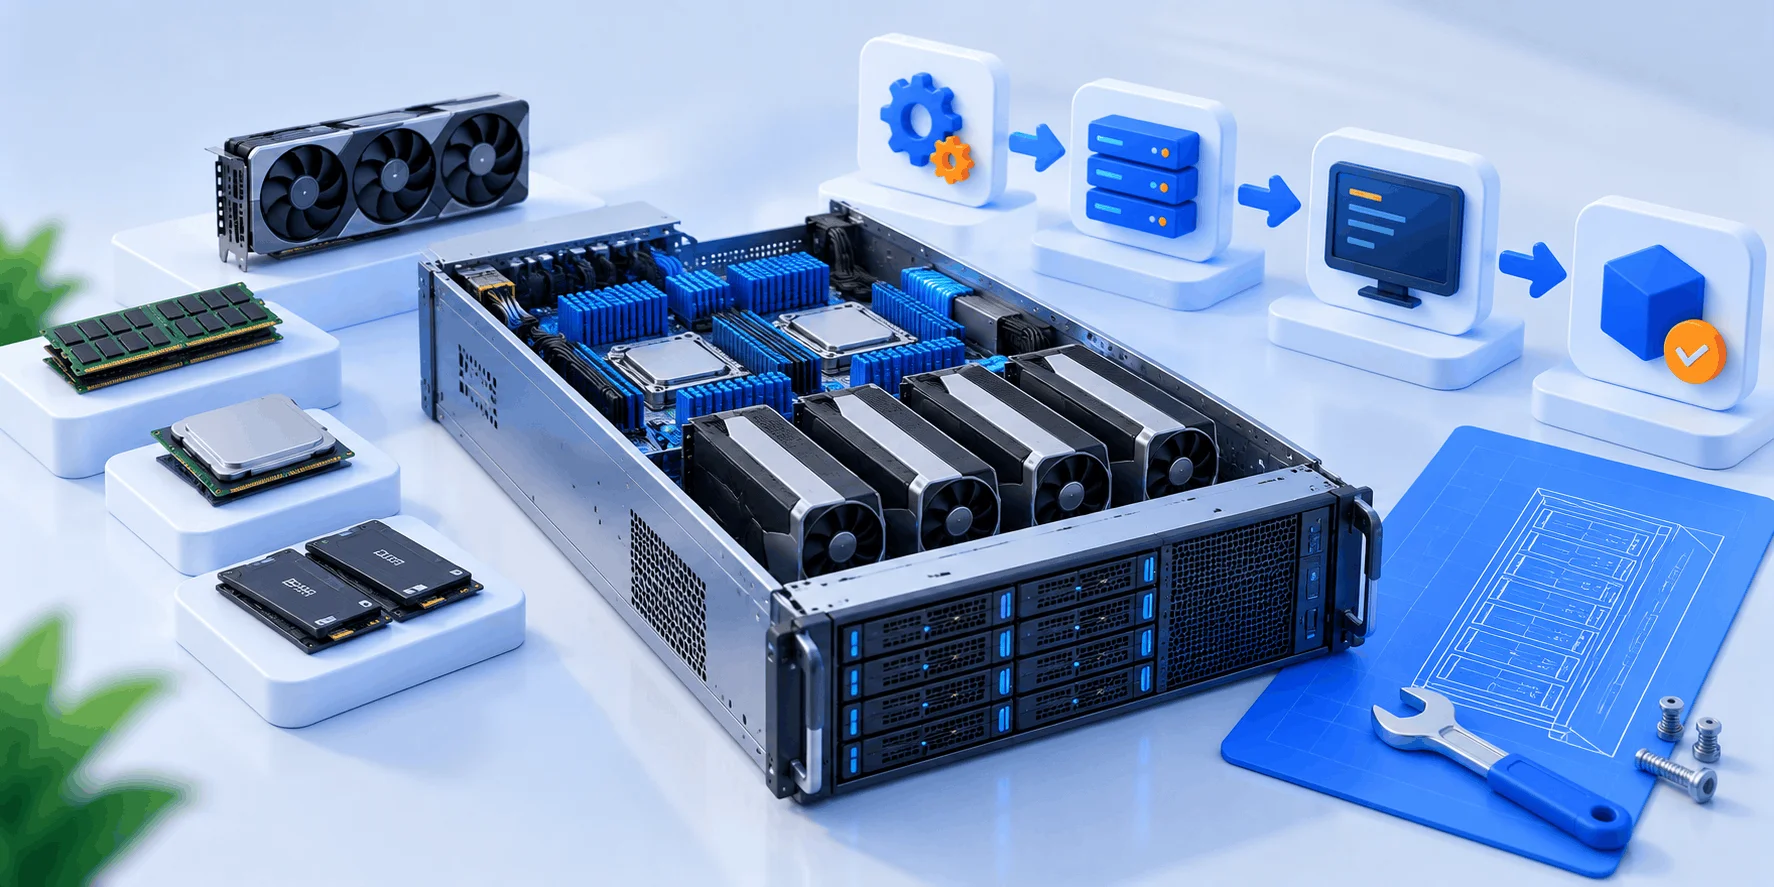
در این بخش همراه تیم وب‌داده باشید تا اجزای یک سرور پردازشی را به ترتیب اهمیت بررسی کنیم و در پایان یک جاب نمونه را با زمان‌بند Slurm اجرا کنیم. معیار انتخاب همیشه «گلوگاه» بار شماست: پردازنده، حافظه، دیسک یا شبکه.

۱- پردازنده؛ تعداد هسته، فرکانس و دستورهای برداری

در پردازش موازی، تعداد هسته مهم‌ترین عدد است، اما تنها عدد نیست. دستورهای برداری (SIMD) مثل AVX2 و AVX-512 به هر هسته اجازه می‌دهند در یک چرخه چند عدد اعشاری را هم‌زمان پردازش کند. طبق مستندات GROMACS، این نرم‌افزار در پایین‌ترین لایه موازی‌سازی، پرتأثیرترین بخش‌های کد را با دستورهای SIMD اجرا می‌کند. هنگام انتخاب پردازنده، این سه حالت را از هم جدا کنید:
◀️ بارهای وابسته به محاسبه (Compute-bound): مثل آزمون HPL و محاسبات جبر خطی متراکم؛ هسته بیشتر و دستورهای برداری جدیدتر اولویت دارند.
◀️ بارهای وابسته به حافظه (Memory-bound): مثل بسیاری از حل‌گرهای CFD؛ تعداد کانال حافظه به ازای هر هسته از فرکانس مهم‌تر است.
◀️ نرم‌افزارهای تک‌رشته‌ای: فرکانس توربوی بالاتر اثر بیشتری از تعداد هسته دارد.

۲- رم؛ ظرفیت به ازای هسته و پهنای باند حافظه

ظرفیت رم تعیین می‌کند مدلی با چه اندازه‌ای اصلاً قابل اجرا باشد و پهنای باند آن تعیین می‌کند هسته‌ها با چه سرعتی داده بگیرند. اینتل برای Xeon E5-2680 v4 چهار کانال حافظه DDR4-2400 و حداکثر پهنای باند 76.8GB/s به ازای هر پردازنده اعلام کرده است. پس در یک سرور دوپردازنده‌ای، ماژول‌های رم باید روی همه کانال‌ها توزیع شوند تا از این ظرفیت استفاده شود.
یک قاعده ساده برای برآورد، تقسیم رم بر تعداد هسته است. برای نمونه، 64GB رم در سروری با 28 هسته فیزیکی یعنی حدود 2.3GB به ازای هر هسته. اگر مدل شما بیشتر می‌خواهد، رم بیشتر را در پیکربندی در نظر بگیرید. در سرورهایی که هفته‌ها بدون توقف محاسبه می‌کنند، رم ECC و اصلاح خودکار خطای حافظه خطر خراب شدن بی‌صدای نتایج را کم می‌کند.

۳- شبکه میان‌گره‌ای؛ InfiniBand یا اترنت

وقتی پردازش موازی بین چند سرور تقسیم می‌شود، شبکه به بخشی از خود محاسبه تبدیل می‌شود. InfiniBand طبق تعریف انجمن تجاری آن (IBTA) یک معماری استاندارد ورودی و خروجی برای اتصال سرورها و ذخیره‌سازهاست. این فناوری با RDMA اجازه می‌دهد داده بدون درگیر کردن پردازنده و هسته سیستم‌عامل، مستقیم بین حافظه دو سرور جابه‌جا شود و تأخیر بسیار پایینی دارد.
برای یک سرور تکی به این شبکه نیازی ندارید. در جاب‌های مستقل و پارامتری هم اترنت معمولی کافی است، چون گره‌ها در طول اجرا با هم حرف نمی‌زنند. اما در شبیه‌سازی‌هایی که در هر گام زمانی داده‌های مرزی را بین گره‌ها رد و بدل می‌کنند، تأخیر شبکه به گلوگاه اصلی تبدیل می‌شود و افزودن گره جدید ممکن است حتی سرعت را کم کند.

۴- ذخیره‌سازی؛ NVMe محلی و فایل‌سیستم موازی

شبیه‌سازی‌ها معمولاً حجم زیادی فایل موقت و خروجی می‌نویسند. در کلاسترهای بزرگ، این کار بر عهده همان فایل‌سیستم‌های موازی ناحیه ذخیره‌سازی است. در یک سرور تکی، دیسک NVMe محلی نقش فضای کاری سریع (Scratch) را بازی می‌کند؛ تفاوت آن را با SSD معمولی در مقایسه هارد NVMe و SSD ببینید.

۵- نرم‌افزار؛ لینوکس، زمان‌بند Slurm و MPI

سیستم‌عامل رایج دنیای HPC لینوکس است و بیشتر ابزارهای این حوزه برای آن ساخته شده‌اند. مستندات رسمی Slurm آن را یک سامانه متن‌باز، مقاوم در برابر خطا و بسیار مقیاس‌پذیر برای مدیریت کلاستر و زمان‌بندی جاب در کلاسترهای لینوکسی کوچک و بزرگ معرفی می‌کند. Slurm گره‌ها را برای مدت مشخص به کاربران تخصیص می‌دهد، اجرای جاب‌های موازی را پایش می‌کند و وقتی منابع کم است، جاب‌ها را در صف نگه می‌دارد.
حتی روی یک سرور تکی که چند پژوهشگر از آن استفاده می‌کنند، نصب Slurm ارزش دارد؛ چون جاب‌ها به‌جای تداخل با هم، به ترتیب اجرا می‌شوند. اسکریپت نمونه زیر یک شبیه‌سازی OpenFOAM را با ۲۸ پردازه MPI اجرا می‌کند:
#!/bin/bash
#SBATCH --job-name=cfd-case
#SBATCH --nodes=1
#SBATCH --ntasks=28
#SBATCH --time=24:00:00

decomposePar
mpirun -np 28 foamRun -parallel > log.foamRun
reconstructPar
این اسکریپت را با دستور sbatch job.sh به صف می‌فرستید، وضعیت آن را با squeue می‌بینید و در صورت نیاز با scancel لغوش می‌کنید. طبق راهنمای OpenFOAM، ابزار decomposePar دامنه را بر اساس فایل decomposeParDict به زیردامنه‌ها تقسیم می‌کند و reconstructPar در پایان نتایج را یکپارچه می‌کند. مقدار numberOfSubdomains در آن فایل باید با تعداد پردازه‌ها برابر باشد.

📌 یادآوری پیش از اجراهای طولانی

هر جاب طولانی را اول با نسخه کوچک‌شده‌ای از مدل آزمایش کنید. ذخیره میانی (Checkpoint) را در نرم‌افزار فعال کنید تا اگر سرور به هر دلیلی ری‌استارت شد، محاسبه چندروزه از صفر شروع نشود. مصرف CPU و رم را هم در طول اجرا زیر نظر داشته باشید.

سناریوی رایج در پشتیبانی وب‌داده

یک سناریوی نمونه: گروهی پژوهشی شبیه‌سازی‌های CFD پایان‌نامه‌ها را روی لپ‌تاپ اجرا می‌کند و هر اجرا تا صبح طول می‌کشد. مسیر پیشنهادی ما این است که روی یک سرور پردازشی اختصاصی، توزیع لینوکس مورد نظر تیم نصب شود، OpenFOAM و Open MPI راه‌اندازی شود و پیش از هر کاری، یک آزمون مقیاس‌پذیری با ۱ تا ۲۸ هسته انجام شود.
اگر شتاب تا ۲۸ هسته همچنان رو به افزایش باشد، هر اجرا با همه هسته‌ها انجام می‌شود. اگر زودتر اشباع شود، چند سناریو با هسته‌های کمتر هم‌زمان اجرا می‌شوند تا ظرفیت سرور هدر نرود. در هر دو حالت، خروجی‌ها روی NVMe نوشته و در پایان هر مرحله به فضای پشتیبان منتقل می‌شوند.

سخت‌افزار مناسب سرور HPC و راه‌اندازی گام‌به‌گام

جدول انتخاب سخت‌افزار بر اساس نوع بار پردازشی

جدول زیر گلوگاه رایج هر نوع بار و سخت‌افزاری را که باید در اولویت قرار دهید، نشان می‌دهد:
نوع بارنمونه نرم‌افزارگلوگاه رایجاولویت سخت‌افزار
CFDOpenFOAM، Fluentپهنای باند حافظهکانال حافظه بیشتر و هسته زیاد
دینامیک مولکولیGROMACSمحاسبه برداریSIMD قوی یا GPU
شیمی کوانتومیGaussian، ORCAرم و دیسک موقترم زیاد و NVMe سریع
جاب‌های پارامتریاسکریپت Python یا Rتعداد هستههسته زیاد و رم متوسط
یادگیری عمیقPyTorchحافظه و توان GPUسرور GPU

سرور پردازشی در وب‌داده؛ اجاره برای دانشگاه‌ها و تیم‌های پژوهشی

اگر بار شما روی CPU اجرا می‌شود و در یک یا چند سرور جا می‌گیرد، سرور اختصاصی HPE وب‌داده نقطه شروع منطقی است. مهم‌ترین مزیت‌های این سرویس برای کار محاسباتی:
✅ دو پردازنده Xeon E5-2680 v4 با مجموع 28 هسته و 56 رشته روی سرور HPE DL360 Gen9، با پشتیبانی از AVX2
✅ 64GB رم Registered ECC DDR4 برای اجراهای طولانی و پایدار
✅ دیسک 1TB NVMe (Samsung 980/990 PRO) برای فضای کاری سریع و فایل‌های موقت
✅ پورت 10 گیگابیت در شبکه‌ای با آپلینک 100 گیگابیت؛ ترافیک فقط بر اساس دانلود محاسبه می‌شود و آپلود رایگان است
✅ نصب خودکار سیستم‌عامل و تحویل آنی پس از پرداخت، مستقل از ساعت اداری
✅ پنل مدیریت با کنسول KVM، ری‌استارت، روشن و خاموش کردن و نصب مجدد سیستم‌عامل
✅ بررسی پیکربندی سفارشی (رم بیشتر، دیسک بیشتر یا نسل‌های دیگر) از طریق تیکت یا تماس و مشاوره فنی شبانه‌روزی پیش از خرید

⚠️ محدودیت‌ها را شفاف بدانید

پلن آماده فعلی کارت گرافیک و شبکه InfiniBand ندارد و برای یادگیری عمیق یا کلاستر MPI با ارتباطات سنگین مناسب نیست. پردازنده Xeon E5-2680 v4 در سه‌ماهه اول 2016 عرضه شده، AVX-512 ندارد و اینتل از 30 ژوئن 2022 آن را در وضعیت پایان به‌روزرسانی‌های سرویس (End of Servicing Updates) قرار داده است. HPE هم DL360 Gen9 را برای ویندوز سرور تا نسخه 2019 تأیید کرده است.

اجاره سرور محاسباتی برای دانشگاه‌ها؛ هزینه و مدت اجاره

هزینه یک سرور پردازشی به پیکربندی آن بستگی دارد: نسل و تعداد پردازنده، ظرفیت رم، دیسک و آی‌پی‌های اضافه. برای دیدن پلن‌ها و قیمت به‌روز، صفحه اجاره سرور اختصاصی را ببینید. مدل اجاره برای پروژه‌های پژوهشی یک مزیت روشن دارد: سرور را فقط برای بازه‌ای می‌گیرید که واقعاً محاسبه دارید، مثلاً فاز شبیه‌سازی یک پایان‌نامه یا طرح پژوهشی.
در این مدل درگیر خرید، استهلاک، برق و خنک‌کاری نمی‌شوید؛ مقایسه دقیق هزینه کل مالکیت در دو حالت را در مقاله خرید سرور یا اجاره سرور اختصاصی آورده‌ایم. برای برآورد مدت اجاره، زمان هر اجرا را در تعداد سناریوها ضرب کنید و حاشیه‌ای هم برای آزمون، خطا و تکرار در نظر بگیرید.
پیش از پایان دوره اجاره، خروجی‌ها را به فضای امن منتقل کنید. هاست بکاپ یا روش‌های خودکار مثل اتوماسیون بکاپ با Cron Job و Rsync برای این کار مناسب‌اند.
✅ بدون هزینه سرمایه‌ای اولیه و هماهنگ با بودجه‌های پژوهشی دوره‌ای
✅ دسترسی مدیریتی کامل و آزادی نصب هر نرم‌افزار، کامپایلر و کتابخانه
✅ بدون صف انتظار کلاستر مشترک؛ همه هسته‌ها در اختیار تیم شماست
❌ برای مدل‌هایی که به صدها گره نیاز دارند، کلاستر ملی یا دانشگاهی گزینه واقع‌بینانه‌تری است.
❌ مدیریت سیستم‌عامل، امنیت و نرم‌افزارها بر عهده تیم شماست، مگر اینکه از خدمات کانفیگ و مدیریت سرور استفاده کنید.

سوالات متداول درباره سرور HPC و پردازش سنگین

سرور HPC با سرور اختصاصی معمولی چه فرقی دارد؟

از نظر سخت‌افزار مرز دقیقی وجود ندارد؛ یک سرور اختصاصی پرهسته با رم کافی می‌تواند یک سرور HPC کوچک باشد. تفاوت در پیکربندی و نوع استفاده است: روی سرور HPC نرم‌افزارهای موازی، کتابخانه‌های MPI و گاهی زمان‌بند جاب نصب می‌شود و سرور به‌جای میزبانی سایت، محاسبه عددی انجام می‌دهد. در مقیاس بزرگ، چند سرور با شبکه پرسرعت و فایل‌سیستم موازی به کلاستر تبدیل می‌شوند.

به مدل شما بستگی دارد. اگر هر اجرا روی لپ‌تاپ چند دقیقه طول می‌کشد، سرور لازم نیست. اما اگر اجراها یک شب یا بیشتر طول می‌کشند، رم سیستم کم می‌آید یا باید ده‌ها سناریو را تکرار کنید، سرور پردازشی زمان پروژه را کوتاه می‌کند. پیش از اجاره مطمئن شوید نرم‌افزار شما از چند هسته استفاده می‌کند؛ نرم‌افزار تک‌هسته‌ای از سرور پرهسته سود چندانی نمی‌برد.

OpenMP برای حافظه مشترک طراحی شده است؛ یعنی رشته‌های یک برنامه داخل یک سرور به یک رم دسترسی دارند. MPI برای حافظه توزیع‌شده است و پردازه‌ها با ارسال پیام داده را جابه‌جا می‌کنند، بنابراین می‌تواند بین چند سرور کار کند. بسیاری از نرم‌افزارهای مهندسی ترکیبی از هر دو را به کار می‌برند و روی یک سرور تکی هر دو روش قابل استفاده‌اند.

عدد ثابتی وجود ندارد. تعداد هسته را با آزمون مقیاس‌پذیری تعیین کنید: مدل را با ۱، ۲، ۴، ۸ و ۱۶ هسته اجرا کنید و ببینید شتاب کجا متوقف می‌شود. برای رم، مصرف واقعی یک اجرای کوچک را اندازه بگیرید و آن را برای اندازه مدل نهایی برآورد کنید. حاشیه‌ای هم برای سیستم‌عامل و فایل‌های موقت بگذارید. اگر پلن آماده کافی نبود، پیکربندی سفارشی را بررسی کنید.

برای استنتاج مدل‌های کوچک و متوسط و پیش‌پردازش داده، CPU پرهسته قابل استفاده است؛ روش آن را در راهنمای راه‌اندازی سرور هوش مصنوعی شخصی با Ollama توضیح داده‌ایم. اما آموزش شبکه‌های عصبی بزرگ روی CPU بسیار کندتر است و به GPU نیاز دارد. پلن آماده وب‌داده کارت گرافیک ندارد و نیاز GPU باید از طریق تیکت یا تماس بررسی شود.

از نظر نرم‌افزاری بله؛ با نصب Slurm، یک پیاده‌سازی MPI مثل Open MPI و یک فایل‌سیستم مشترک می‌توان چند سرور را به کلاستر تبدیل کرد. محدودیت اصلی شبکه است: کلاسترهای جدی از InfiniBand یا اترنت کم‌تأخیر استفاده می‌کنند و برنامه‌های پرارتباط روی شبکه معمولی خوب مقیاس نمی‌شوند. برای جاب‌های مستقل و پارامتری، شبکه معمولی کافی است. نیازهای شبکه را پیش از خرید با کارشناسان وب‌داده در میان بگذارید.

Slurm یک مدیر کلاستر و زمان‌بند جاب متن‌باز برای لینوکس است که منابع را به کاربران تخصیص می‌دهد و جاب‌ها را در صف نگه می‌دارد. اگر فقط یک نفر از سرور استفاده می‌کند، اجرای مستقیم برنامه یا ابزاری مثل tmux کافی است. اما وقتی چند پژوهشگر یک سرور مشترک دارند، Slurm جلوی تداخل جاب‌ها و اشغال همه هسته‌ها توسط یک نفر را می‌گیرد.

سرور اختصاصی فقط در اختیار شماست و سخت‌افزار آن با کاربر دیگری تقسیم نمی‌شود، اما امنیت سیستم‌عامل و دسترسی‌ها بر عهده مدیر سرور است. ورود با کلید SSH، بستن پورت‌های غیرضروری، به‌روزرسانی منظم و نسخه پشتیبان خارج از سرور حداقل اقدامات لازم‌اند. وب‌داده محافظت DDoS و فایروال سخت‌افزاری دارد، ولی این لایه‌ها جایگزین تنظیمات امنیتی داخل سرور نیستند.

جمع‌بندی؛ پردازش سنگین را با سخت‌افزار درست شروع کنید

سرور محاسباتی ابزاری برای کوتاه کردن زمان رسیدن به نتیجه است. در این مقاله دیدیم HPC بر پایه پردازش موازی کار می‌کند، کلاسترهای بزرگ طبق معماری NIST از ناحیه‌های دسترسی، محاسبه، ذخیره‌سازی و مدیریت ساخته می‌شوند و قانون امدال یادآوری می‌کند که هسته بیشتر همیشه سرعت بیشتر نمی‌آورد. همچنین دیدیم هر نوع بار گلوگاه خودش را دارد: CFD به پهنای باند حافظه، شیمی کوانتومی به رم و دیسک و یادگیری عمیق به GPU حساس است.
توصیه نهایی ما ساده است: اول نرم‌افزار خود را روی چند هسته آزمایش کنید، گلوگاه را پیدا کنید و بعد سخت‌افزار را انتخاب کنید. برای بسیاری از پروژه‌های دانشگاهی و مهندسی، یک سرور اختصاصی دوپردازنده‌ای با رم ECC و دیسک NVMe شروع مطمئنی است و وقتی مقیاس کار بزرگ‌تر شد، می‌توانید سراغ کلاستر یا سرور GPU بروید. وب‌داده با تحویل آنی، پنل مدیریت کامل و بررسی پیکربندی سفارشی، این مسیر را برای تیم‌های پژوهشی ساده‌تر می‌کند.
در صورتی که سوالی داشتید می‌توانید در بخش نظرات با ما در ارتباط باشید.
امیدوارم این مقاله از بلاگ وب‌داده برای شما مفید بوده باشد.
وب داده
وب داده

جدید ترین مطالب آموزشی و کاربردی را در اینجا بخوانید !
ما با بهره‌گیری از دانش روز و تجربه متخصصان حوزه فناوری، مجموعه‌ای از آموزش‌های کاربردی و مقالات تخصصی را گردآوری کرده‌ایم که هر یک، پاسخی دقیق به پرسش‌های شماست. ؛ از مفاهیم پایه تا پیچیده‌ترین تکنیک‌های حرفه‌ای. اینجا، دانش با زبانی ساده اما عمیق در اختیار شما قرار می‌گیرد.

مقاله‌ها: 227
پاسخی بگذارید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *