سرور و دیتاسنتر | بلاگ وب‌داده

سرور هوش مصنوعی چیست و برای آموزش و اجرای مدل‌های AI چه سخت‌افزاری لازم است؟

از GPU و VRAM تا رم، پهنای باند و کوانتیزاسیون؛ ببینید هر پروژه AI چه سخت‌افزاری می‌خواهد و کجا یک سرور CPU با رم بالا برای شروع کافی است.

💡 خلاصه مقاله در ۳ خط

✅ سرورهای ویژه AI دو کار اصلی دارند: آموزش مدل با نیاز شدید به GPU و حافظه، و استنتاج یعنی اجرای روزمره مدل.
✅ در اجرای مدل‌های زبانی، ظرفیت و پهنای باند حافظه به اندازه قدرت محاسباتی مهم است و کوانتیزاسیون نیاز به رم را چند برابر کم می‌کند.
✅ برای پایلوت و بار سبک، سرور CPU با رم بالا کافی است؛ آموزش و بار سنگین به GPU یا کولوکیشن سخت‌افزار اختصاصی نیاز دارد.
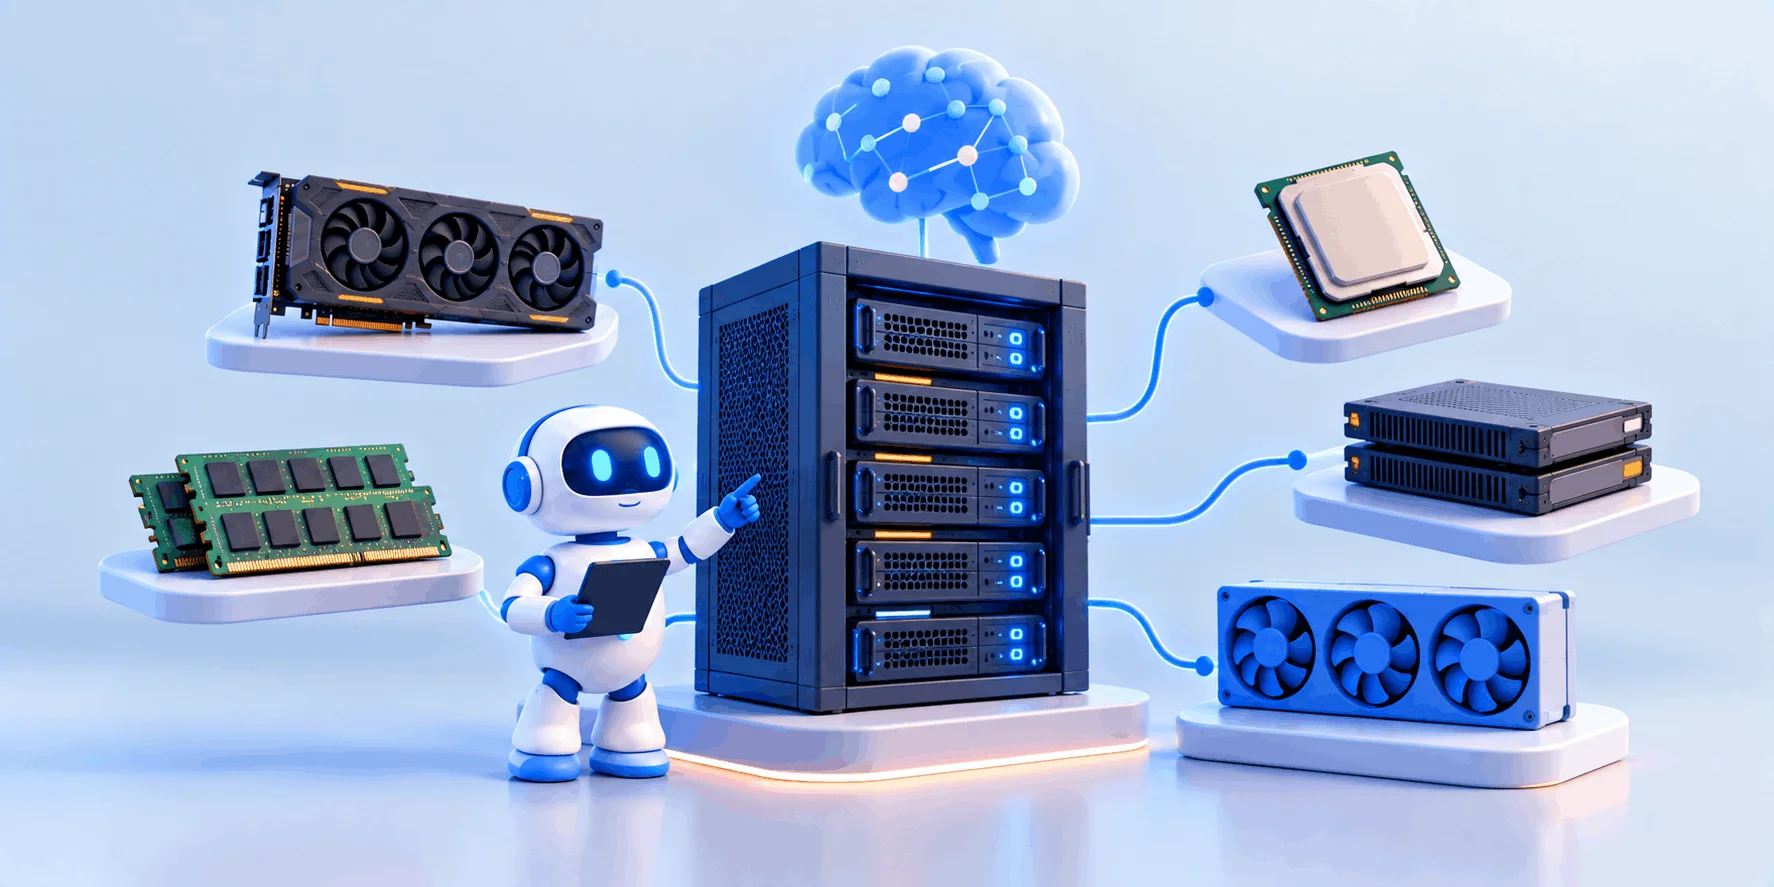
سرور هوش مصنوعی سروری است که سخت‌افزارش برای بارهای کاری یادگیری ماشین و یادگیری عمیق انتخاب و پیکربندی شده است: پردازش موازی قدرتمند (معمولاً GPU)، حافظه پرظرفیت و پرسرعت، دیسک NVMe و شبکه سریع. تفاوت اصلی آن با سرور معمولی این است که گلوگاهش به‌جای دیسک یا تعداد درخواست وب، اغلب حافظه و محاسبات ماتریسی است.
✅ سخت‌افزار نامناسب یعنی مدلی که در حافظه جا نمی‌شود یا پاسخ‌هایش بیش از حد کند است.
✅ اجرای مدل روی سرور خودتان، کنترل داده‌ها را در اختیار شما نگه می‌دارد.
✅ بسیاری از پروژه‌ها فقط به استنتاج نیاز دارند و بدون GPU هم قابل شروع هستند.

💡 سرور هوش مصنوعی = سخت‌افزار متناسب با آموزش یا اجرای مدل

✅ معیار اصلی انتخاب، اندازه مدل و نوع کار است، نه فقط تعداد هسته‌ها.
✅ سرور اختصاصی HPE با رم ECC و دیسک NVMe برای استنتاج روی CPU، در وب‌داده
حتماً زمانی که این مقاله را باز کرده‌اید، به دنبال این هستید که بدانید برای اجرای یک مدل زبانی یا ساخت چت‌بات سازمانی چه سروری لازم دارید و آیا بدون GPU هم می‌شود شروع کرد. در این راهنمای کامل، گام‌به‌گام نقش CPU، GPU و رم، محاسبه حافظه و روش اجرای مدل روی سرور را با تکیه بر منابع رسمی بررسی می‌کنیم. پس همراه ما باشید 😉👇

🔶 سرور اختصاصی HPE برای استنتاج روی CPU

پلن آماده سرور اختصاصی ایران وب‌داده با دو Xeon E5-2680 v4 و 64GB رم ECC، برای مدل‌های کوانتیزه و سرویس‌های سبک AI مناسب است. این پلن GPU ندارد؛ نیاز GPU را از طریق تیکت یا تماس مطرح کنید تا بررسی شود. 👇

سرور هوش مصنوعی چیست و چه فرقی با سرور معمولی دارد؟

شبکه‌های عصبی، از تشخیص تصویر تا مدل‌های زبانی بزرگ (LLM)، در اصل میلیاردها عدد به نام پارامتر یا وزن هستند که پیوسته از حافظه خوانده و در هم ضرب می‌شوند. پس کیفیت سرور AI با سه معیار سنجیده می‌شود: توان محاسبات موازی، ظرفیت حافظه و سرعت انتقال داده بین حافظه و پردازنده.
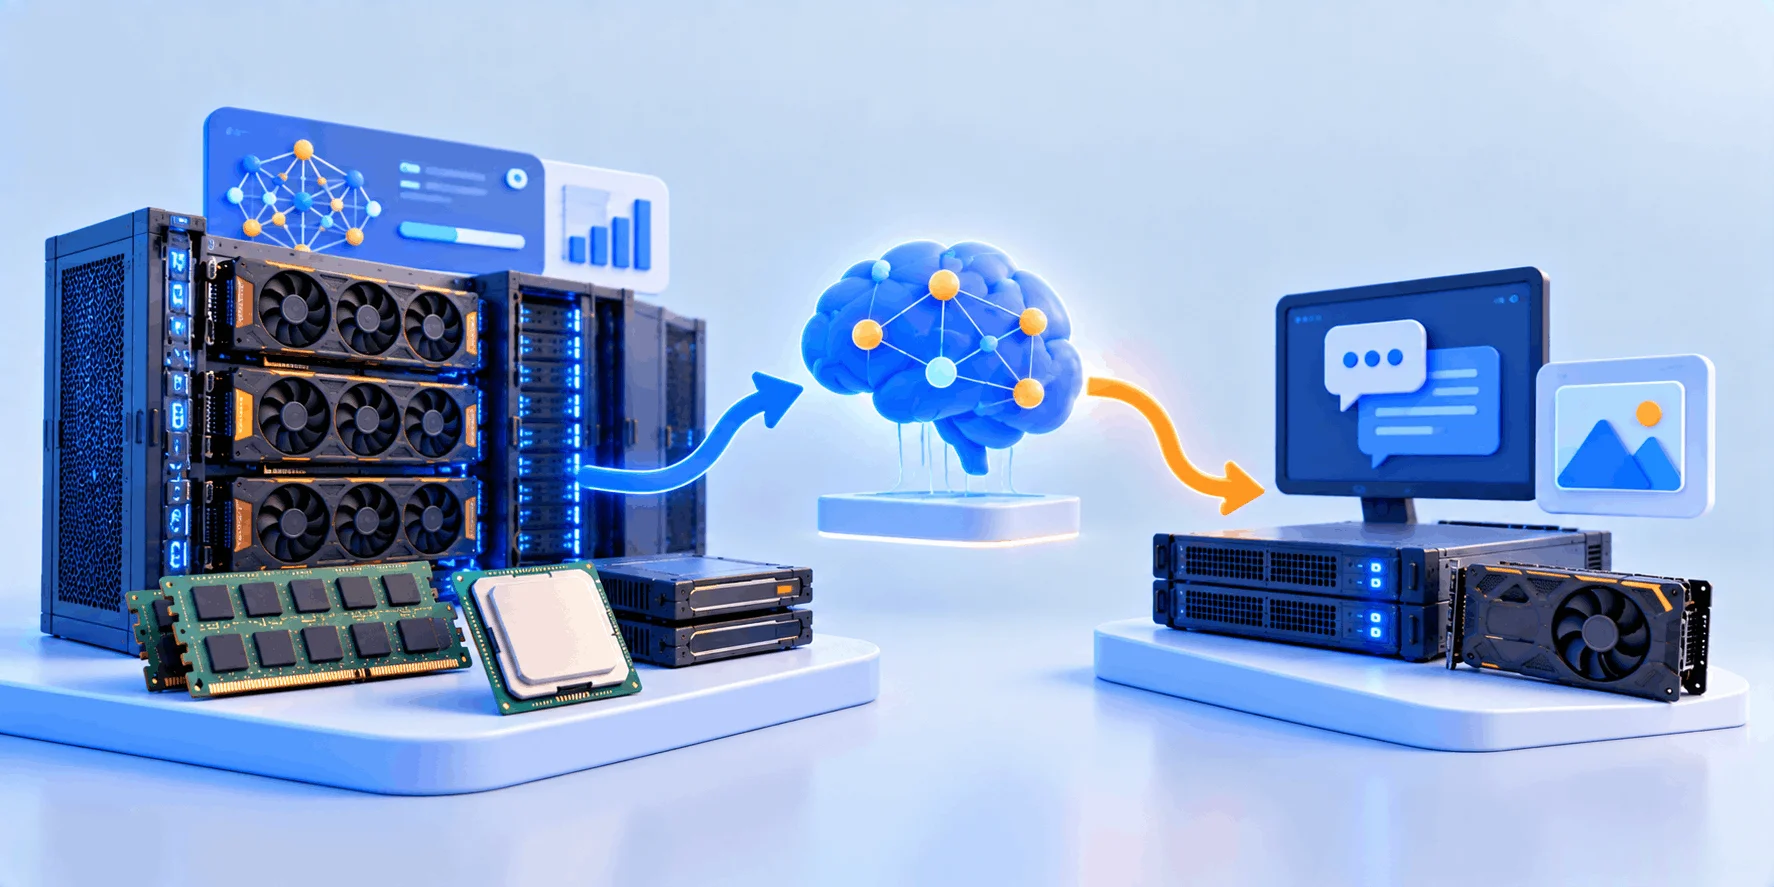
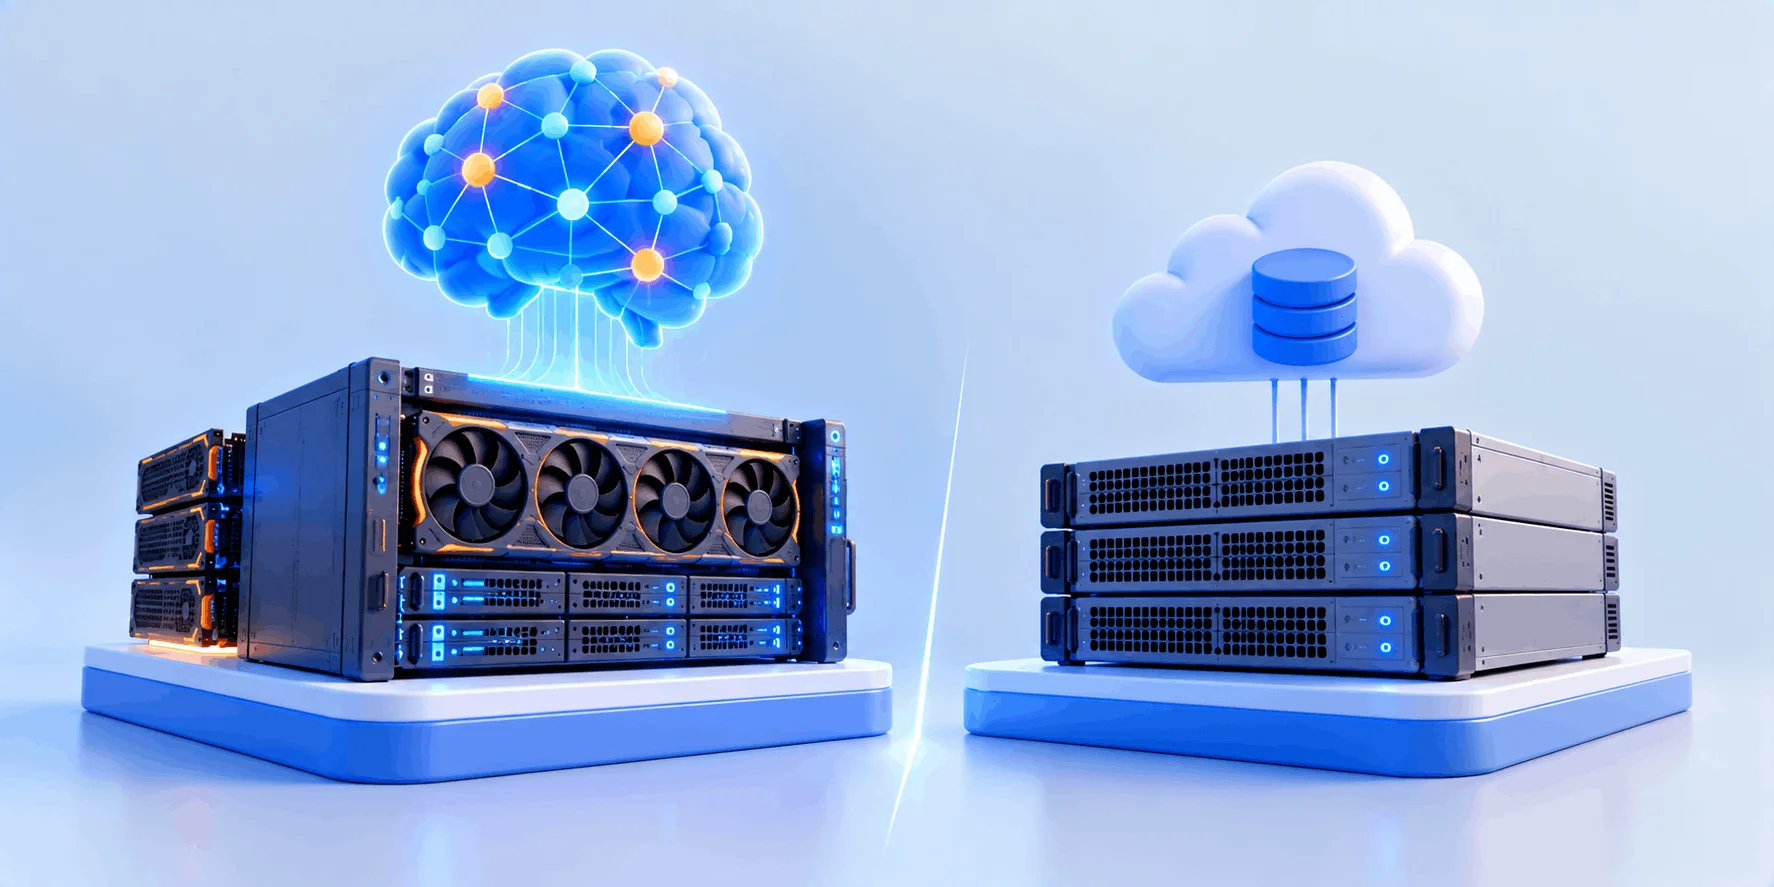
یک رستوران را تصور کنید. آموزش مدل مثل تدوین کتاب دستور پخت است: ماه‌ها آزمون و خطا و آشپزخانه‌ای بزرگ می‌خواهد. استنتاج (Inference) مثل پخت سفارش‌های روزانه از روی همان کتاب است؛ سبک‌تر، اما سریع و بی‌وقفه. بیشتر کسب‌وکارها از مدل‌های متن‌باز آموزش‌دیده استفاده می‌کنند و فقط به آشپزخانه پخت نیاز دارند.
Dataset ➡️ [ Training: GPU cluster, BF16/FP16 ] ➡️ Model weights
                                                  ⬇️
                                    Quantize (INT8 / 4-bit, GGUF)
                                                  ⬇️
User prompt ➡️ [ Inference: GPU or high-RAM CPU ] ➡️ Answer (tokens)
۱- آموزش مدل (Training)؛ سنگین‌ترین بار کاری

در آموزش مدل، شبکه بارها داده را می‌بیند و وزن‌هایش را با بهینه‌سازهایی مانند AdamW اصلاح می‌کند. طبق مستندات Hugging Face، در آموزش با دقت ترکیبی (mixed precision) هر پارامتر حدود ۱۸ بایت حافظه می‌گیرد: ۶ بایت وزن‌ها، ۸ بایت وضعیت بهینه‌ساز و ۴ بایت گرادیان، بدون احتساب اکتیویشن‌ها. به همین دلیل آموزش کامل حتی مدل‌های نسبتاً کوچک چند GPU پرحافظه می‌خواهد.

۲- استنتاج (Inference)؛ اجرای روزمره مدل

در استنتاج، مدل آموزش‌دیده ورودی کاربر را می‌گیرد و پاسخ می‌سازد؛ فقط وزن‌ها و کمی حافظه موقت لازم است. طبق وبلاگ فنی NVIDIA، مدل Llama 2 7B با دقت ۱۶ بیتی حدود 14GB حافظه می‌گیرد. اجرای یک مدل زبانی دو مرحله دارد: پردازش پرامپت (prefill) که موازی و محاسبه‌محور است و تولید توکن‌به‌توکن پاسخ (decode) که به سرعت خواندن حافظه وابسته است.

سرور هوش مصنوعی چیست و چه فرقی با سرور معمولی دارد؟

🔸 نکته فنی: گلوگاه اصلی استنتاج

NVIDIA مرحله decode را «محدود به حافظه» (memory-bound) می‌داند؛ یعنی سرعت انتقال داده از حافظه، بیش از سرعت محاسبه، زمان پاسخ را تعیین می‌کند. پس در انتخاب سرور، پهنای باند حافظه را هم‌وزن تعداد هسته‌ها ببینید.

چرا به زیرساخت اختصاصی AI نیاز داریم؟

داده مشتری، اسناد داخلی یا کد منبع را هر سازمانی نمی‌خواهد به API خارجی بفرستد؛ دسترسی به برخی سرویس‌های خارجی و پرداخت هزینه آن‌ها از ایران هم محدود یا ناپایدار است. اجرای مدل متن‌باز روی سرور اختصاصی این وابستگی را کم می‌کند:
✅ حریم خصوصی: پرامپت‌ها، اسناد و پاسخ‌ها روی سرور خودتان می‌مانند.
✅ تأخیر کمتر: سرور نزدیک به کاربران داخلی، زمان رفت‌وبرگشت شبکه را کم می‌کند.
✅ کنترل کامل: نسخه مدل، سطح کوانتیزاسیون و تنظیمات پاسخ را خودتان انتخاب می‌کنید.
✅ هزینه قابل پیش‌بینی: به‌جای پرداخت به ازای هر توکن، هزینه ثابت زیرساخت را برنامه‌ریزی می‌کنید.
❌ راه‌اندازی و نگهداری مدل، دانش لینوکس، شبکه و امنیت می‌خواهد.
❌ مدل‌های متن‌باز کوچک در کارهای پیچیده لزوماً به کیفیت سرویس‌های تجاری بزرگ نمی‌رسند.
❌ GPU دیتاسنتری گران است و برق و خنک‌سازی جدی می‌خواهد.

سخت‌افزار لازم برای آموزش مدل و استنتاج

هیچ قطعه‌ای به‌تنهایی تعیین‌کننده نیست؛ GPU قوی کنار رم کم همان‌قدر ناکارآمد است که CPU پرهسته بدون حافظه کافی. هر جزء را با اعداد رسمی سازندگان مرور می‌کنیم.

۱- GPU و حافظه VRAM

GPU هزاران هسته ساده برای محاسبات ماتریسی هم‌زمان دارد و GPUهای دیتاسنتری NVIDIA برای همین کار هسته‌های Tensor دارند. اما مهم‌ترین عدد برگه مشخصات، ظرفیت و پهنای باند حافظه (VRAM) است؛ اگر مدل در VRAM جا نشود، بخشی از آن باید روی CPU اجرا شود و سرعت به‌شدت افت می‌کند.
توان مصرفی را هم جدی بگیرید: H100 SXM به‌تنهایی تا 700W مصرف می‌کند، در حالی که TDP هر پردازنده E5-2680 v4 برابر 120W است. پس سرور میزبان باید اسلات PCIe، منبع تغذیه و جریان هوای مناسب کارت را داشته باشد (نمونه: مشخصات رسمی NVIDIA L40S).

۲- پردازنده (CPU) و شتاب‌دهنده‌های داخلی

در سرور بدون GPU، خود CPU استنتاج را انجام می‌دهد و دستورالعمل‌های برداری تعیین‌کننده می‌شوند؛ llama.cpp روی x86 از AVX، AVX2، AVX-512 و AMX پشتیبانی می‌کند. طبق Intel ARK، Xeon E5-2680 v4 با ۱۴ هسته و ۲۸ رشته AVX2 دارد، اما AVX-512 و AMX ندارد. به اعلام Intel، AMX در Xeon نسل چهارم و پنجم و Xeon 6 با هسته‌های P وجود دارد و BF16 را برای آموزش و استنتاج و INT8 را برای استنتاج شتاب می‌دهد. مقایسه Xeon و EPYC را در راهنمای CPU سرور ببینید.

۳- رم و پهنای باند حافظه

در استنتاج روی CPU، رم نقش VRAM را بازی می‌کند. قاعده Hugging Face ساده است: مدلی با X میلیارد پارامتر در دقت bfloat16 یا float16 حدود 2X گیگابایت و در float32 حدود 4X گیگابایت حافظه می‌خواهد. KV cache هم با طول مکالمه به‌صورت خطی رشد می‌کند و باید برای آن و سیستم‌عامل فضای اضافه گذاشت.
مزیت سرورهای دو سوکتی ظرفیت رم است: E5-2680 v4 طبق Intel ARK تا 1.5TB رم DDR4 را روی ۴ کانال پشتیبانی می‌کند. اما سقف پهنای باند حافظه هر سوکت 76.8GB/s است، در حالی که H100 SXM به 3.35TB/s می‌رسد؛ پس CPU مدل بزرگ را جا می‌دهد، اما کندتر اجرا می‌کند. برای مبانی انتخاب ظرفیت، مقاله «رم سرور مجازی چقدر باشد؟» را ببینید.

۴- ذخیره‌سازی NVMe و شبکه

فایل‌های مدل چندین گیگابایت حجم دارند و با هر راه‌اندازی از دیسک به حافظه بارگذاری می‌شوند؛ دیسک NVMe این کار را بسیار سریع‌تر می‌کند (مقایسه هارد NVMe و SSD). در شبکه، ارسال پاسخ متنی به‌ندرت گلوگاه است، اما در آموزش توزیع‌شده GPUها پیوسته داده رد و بدل می‌کنند؛ برای همین H100 SXM از NVLink با 900GB/s بهره می‌برد.

سخت‌افزار لازم برای آموزش مدل و استنتاج

مقایسه پهنای باند حافظه CPU و GPU

جدول زیر اعداد رسمی Intel و NVIDIA را کنار هم می‌گذارد تا ببینید چرا در استنتاج، ظرفیت و سرعت حافظه دو کفه یک ترازو هستند:
سخت‌افزارظرفیت حافظهپهنای باند حافظهتوان (TDP)
Xeon E5-2680 v4 (هر سوکت)تا 1.5TB رم DDR476.8GB/s120W
NVIDIA L424GB300GB/s72W
NVIDIA L40S48GB GDDR6 با ECC864GB/s350W
NVIDIA H100 SXM80GB3.35TB/sتا 700W
GPUهای دیتاسنتری در سرعت حافظه از چند برابر تا ده‌ها برابر جلوترند، اما CPU با رم پرظرفیت، مدل‌های بزرگ‌تر را بدون کارت گرافیک بارگذاری می‌کند. پس ببینید سرعت پاسخ برایتان مهم‌تر است یا اندازه مدل و هزینه.

جدول حافظه لازم برای اجرای مدل زبانی

با قاعده Hugging Face می‌توانید حافظه لازم را پیش از خرید یا اجاره محاسبه کنید: تعداد پارامترها (به میلیارد) × بایت هر پارامتر. هر پارامتر در FP16 دو بایت، در INT8 یک بایت و در کوانتیزاسیون ۴ بیتی حدود نیم بایت می‌گیرد. اعداد جدول فقط حجم وزن‌ها هستند و KV cache و سیستم‌عامل را شامل نمی‌شوند.
اندازه مدلFP16/BF16INT8۴ بیتی
7Bحدود 14GBحدود 7GBحدود 3.5GB
13Bحدود 26GBحدود 13GBحدود 6.5GB
70Bحدود 140GBحدود 70GBحدود 35GB

⚠️ محدودیت مهم: آموزش مدل روی CPU

با حدود ۱۸ بایت برای هر پارامتر، آموزش کامل مدل 7B بیش از 120GB حافظه فقط برای وزن‌ها، گرادیان‌ها و وضعیت بهینه‌ساز می‌خواهد و روی CPU عملاً کاربردی نیست. روش LoRA وزن‌های اصلی را ثابت نگه می‌دارد و فقط ماتریس‌های کوچک به‌روزرسانی را آموزش می‌دهد، اما این روش هم روی GPU بسیار سریع‌تر است.

آموزش اجرای مدل زبانی روی سرور CPU

در این بخش همراه تیم وب‌داده باشید تا اجرای یک مدل زبانی متن‌باز را روی سرور لینوکسی بدون GPU قدم‌به‌قدم مرور کنیم. ابزار پیشنهادی ما llama.cpp است؛ پروژه‌ای متن‌باز برای اجرای مدل‌های زبانی با کمترین تنظیمات روی سخت‌افزارهای متنوع.

۱- انتخاب مدل و سطح کوانتیزاسیون

اول کاربرد را مشخص کنید: پاسخ به مشتری، خلاصه‌سازی اسناد یا کمک به برنامه‌نویسی. برای شروع روی CPU، مدل‌های ۷ تا ۸ میلیارد پارامتری با کوانتیزاسیون ۴ بیتی انتخاب معقولی‌اند، چون در رم جا می‌شوند و سریع‌تر پاسخ می‌دهند. llama.cpp از کوانتیزاسیون عدد صحیح ۱٫۵ تا ۸ بیتی پشتیبانی می‌کند و مدل‌ها را در قالب GGUF اجرا می‌کند.
◀️ مجوز (License) مدل را برای استفاده تجاری بررسی کنید.
◀️ کوانتیزاسیون پایین‌تر حافظه را کم می‌کند، اما ممکن است دقت پاسخ‌ها را کاهش دهد.
◀️ context طولانی‌تر، حجم KV cache و مصرف رم را بالا می‌برد.

۲- آماده‌سازی سرور و ساخت llama.cpp

روی توزیعی به‌روز مانند Ubuntu Server، ابزارهای git، cmake و کامپایلر C++ را نصب کنید و طبق مستندات رسمی، پروژه را با CMake بسازید؛ فایل‌های اجرایی در build/bin قرار می‌گیرند. برای اجرای ایزوله سرویس‌ها، نصب داکر روی اوبونتو 24.04 را ببینید.
sudo apt update && sudo apt install -y git cmake build-essential
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build
cmake --build build --config Release -j 28

۳- اجرای llama-server و تنظیم NUMA

llama-server یک API سازگار با OpenAI روی مسیر /v1/chat/completions ارائه می‌دهد؛ پس بیشتر ابزارهای سازگار با OpenAI با تغییر آدرس به سرور شما وصل می‌شوند. این سرویس به‌صورت پیش‌فرض روی 127.0.0.1 و پورت 8080 اجرا می‌شود؛ گزینه -t تعداد رشته‌ها و گزینه -c طول context را تعیین می‌کند.
./build/bin/llama-server -m models/model-Q4_K_M.gguf \
  -t 28 -c 8192 --numa distribute \
  --host 127.0.0.1 --port 8080 --api-key YOUR_SECRET_KEY
در سرورهای دو سوکتی مانند HPE DL360 Gen9، هر پردازنده به بخشی از رم دسترسی مستقیم دارد (NUMA). گزینه --numa حالت‌های distribute، isolate و numactl را دارد و طبق مستندات، اگر قبلاً بدون آن اجرا کرده‌اید، پیش از استفاده کش صفحات سیستم را خالی کنید. تعداد بهینه رشته‌ها را هم با آزمایش پیدا کنید.

📌 یک تخمین سرانگشتی برای سرعت پاسخ

سقف نظری سرعت تولید توکن تقریباً برابر پهنای باند حافظه تقسیم بر حجم وزن‌هاست. مثلاً مدل 7B چهار بیتی (حدود 3.5GB) روی یک سوکت با 76.8GB/s سقفی حدود ۲۰ توکن در ثانیه دارد. این عدد بنچمارک نیست و سرعت واقعی معمولاً کمتر است.

۴- امنیت و انتشار API

API مدل را هرگز بدون احراز هویت روی اینترنت باز نکنید: llama-server را روی 127.0.0.1 نگه دارید، با --api-key کلید تعریف کنید و دسترسی بیرونی را از طریق reverse proxy مانند Nginx با TLS بدهید. سرور را هم طبق آموزش Hardening لینوکس ایمن کنید.
۵- پایش منابع و ارزیابی کیفیت

مصرف رم، بار CPU و زمان پاسخ را با ابزارهایی مانند Netdata و Glances زیر نظر بگیرید (آموزش مانیتورینگ با Netdata و Glances). کیفیت پاسخ‌ها را هم با پرسش‌های واقعی کسب‌وکار خودتان بسنجید، نه فقط نمونه‌های عمومی.

آموزش اجرای مدل زبانی روی سرور CPU

مزایا و محدودیت‌های استنتاج روی CPU

✅ بدون کارت گرافیک و روی سرور اختصاصی معمولی قابل شروع است.
✅ رم پرظرفیت، مدل‌هایی بزرگ‌تر از VRAM بسیاری از GPUها را جا می‌دهد.
✅ برای پایلوت، چت‌بات داخلی کم‌کاربر و پردازش دسته‌ای مناسب است.
❌ سرعت تولید توکن به‌مراتب کمتر از GPU است و با افزایش کاربران هم‌زمان افت می‌کند.
❌ پردازنده‌های نسل قدیم‌تر از AVX-512 و AMX بی‌بهره‌اند.
❌ مدل‌های سنگین تصویری و ویدیویی معمولاً به GPU نیاز دارند.

📚 از منابع معتبر

وبلاگ فنی NVIDIA توضیح می‌دهد که در مرحله decode، سرعت انتقال داده از حافظه، و نه سرعت محاسبه، زمان پاسخ را تعیین می‌کند. مستندات Hugging Face هم برای برآورد حافظه، حدود ۲ گیگابایت به ازای هر میلیارد پارامتر در دقت ۱۶ بیتی را پیشنهاد می‌کند. این دو اصل، پایه محاسبات این مقاله‌اند.

یک سناریوی نمونه: چت‌بات داخلی بدون GPU

فرض کنید یک شرکت نرم‌افزاری دستیاری می‌خواهد که از روی مستندات داخلی به کارکنان پاسخ دهد و اسناد از سرور شرکت خارج نشوند؛ درخواست اولیه‌اش هم سرور GPU‌دار است. کارشناس فنی ابتدا سه چیز را می‌پرسد: تعداد کاربران هم‌زمان، حجم اسناد و زمان پاسخ قابل‌قبول.
اگر کاربران هم‌زمان محدود باشند، مسیر پیشنهادی پایلوتی روی سرور CPU با رم بالاست: مدل ۸ میلیارد پارامتری کوانتیزه با llama.cpp، دیتابیس برداری برای جست‌وجوی اسناد (RAG) و API پشت reverse proxy. پس از چند هفته، تصمیم درباره GPU یا کولوکیشن بر پایه داده واقعی مصرف گرفته می‌شود.

HPE DL380 Gen11 و GPU؛ چه زمانی ارتقا دهیم؟

وقتی کاربران یا اندازه مدل از توان CPU فراتر رفت، نوبت نسل جدیدتر و GPU است. طبق صفحه محصول HPE، سرور 2U مدل ProLiant DL380 Gen11 از Xeon Scalable نسل چهارم و پنجم با حداکثر ۶۴ هسته، تا 8TB حافظه DDR5 با سرعت تا 5600MT/s، PCIe Gen5 و تا ۸ GPU تک‌عرض یا ۳ GPU دوعرض پشتیبانی می‌کند. سازگاری هر مدل کارت را در QuickSpecs HPE بررسی کنید. جزئیات این نسل را در معرفی سرور HP G11 مرور کرده‌ایم.
◀️ 🎯 CPU با رم بالا: پایلوت، چت‌بات داخلی کم‌کاربر، ساخت embedding و پردازش دسته‌ای.
◀️ 🎯 CPU نسل جدید با AMX: استنتاج سریع‌تر مدل‌های کوچک و متوسط با BF16 یا INT8.
◀️ 🎯 یک GPU مانند L4 یا L40S: سرویس تعاملی با کاربران هم‌زمان بیشتر و مدل‌های تصویری.
◀️ 🎯 چند GPU با NVLink: آموزش و تنظیم دقیق مدل‌های بزرگ.
📌 مقالات تخصصی این مجموعه: اگر مسیر خود را مشخص کرده‌اید، این راهنماها جزئیات هر کاربرد را بررسی می‌کنند:

سرور اختصاصی هوش مصنوعی در وب‌داده؛ استنتاج روی CPU

اگر به دنبال اجاره سرور هوش مصنوعی در ایران هستید، از همین ابتدا شفاف بگوییم: پلن آماده سرور اختصاصی وب‌داده کارت گرافیک ندارد. این پلن برای استنتاج مدل‌های کوانتیزه روی CPU، چت‌بات و دستیار داخلی، دیتابیس برداری و APIهای هوش مصنوعی گزینه مناسبی است:
✅ HPE ProLiant DL360 Gen9 با دو Xeon E5-2680 v4؛ مجموعاً ۲۸ هسته و ۵۶ رشته
✅ 64GB رم Registered ECC DDR4 و 1TB دیسک NVMe (Samsung 980/990 PRO)
✅ پورت 10Gbit/s روی شبکه‌ای با uplink صد گیگابیتی
✅ نصب خودکار سیستم‌عامل، تحویل آنی پس از پرداخت و پنل مدیریت سرور
✅ محافظت DDoS با ظرفیت 100Gbit/s و فایروال سخت‌افزاری
✅ محاسبه ترافیک فقط بر اساس دانلود؛ آپلود رایگان است
✅ بررسی پیکربندی سفارشی (رم و فضای بیشتر، پورت، IP یا نسل‌های دیگر) از طریق تیکت یا تماس

🔶 به GPU نیاز دارید؟

وب‌داده در پلن آماده سرور GPU‌دار ارائه نمی‌کند. دو مسیر دارید: نیاز خود را از طریق تیکت یا تماس مطرح کنید تا امکان پیکربندی سفارشی بررسی شود، یا سخت‌افزار GPU‌دار خودتان را با کولوکیشن سرور در دیتاسنتر مستقر کنید. تیم فنی ۲۴ ساعته برای مشاوره پیش از خرید در دسترس است.
برای راه‌اندازی اولیه، خدمات کانفیگ و مدیریت سرور هم در دسترس است و مشخصات کامل پلن را در صفحه اجاره سرور اختصاصی می‌بینید.
🚀 بیشتر بدانید: برای راه‌اندازی دستیار AI شخصی، آموزش نصب OpenClaw روی سرور مجازی را بخوانید. مقاله‌های تفاوت سرور مجازی و اختصاصی و سرور اختصاصی چیست؟ هم برای انتخاب بهتر مفیدند.

سوالات متداول درباره سرورهای هوش مصنوعی

آیا بدون GPU می‌توان مدل زبانی را روی سرور اجرا کرد؟

بله. llama.cpp استنتاج را روی CPU با دستورالعمل‌هایی مانند AVX2، AVX-512 و AMX انجام می‌دهد و مدل‌های کوانتیزه کوچک و متوسط روی سروری با رم کافی اجرا می‌شوند. محدودیت اصلی سرعت است: پاسخ کندتر از GPU تولید می‌شود و با افزایش کاربران هم‌زمان افت می‌کند؛ پس این روش برای پایلوت و بار سبک مناسب است. پردازنده‌های قدیمی‌تر مانند Xeon E5-2680 v4 که AVX-512 و AMX ندارند، کندتر عمل می‌کنند.

طبق قاعده Hugging Face، هر میلیارد پارامتر در دقت ۱۶ بیتی حدود ۲ گیگابایت می‌خواهد؛ یعنی حدود 16GB. با کوانتیزاسیون ۸ بیتی حدود 8GB و با ۴ بیتی حدود 4GB برای وزن‌ها کافی است. KV cache، حافظه سیستم‌عامل و سایر سرویس‌ها را هم به این عدد اضافه کنید و حاشیه امن بگذارید.

در آموزش با دقت ترکیبی و AdamW، هر پارامتر حدود ۱۸ بایت حافظه می‌گیرد، به‌علاوه اکتیویشن‌ها؛ برای همین آموزش مدل‌های زبانی تقریباً همیشه روی GPU انجام می‌شود. استنتاج فقط وزن‌ها و KV cache را لازم دارد و با کوانتیزاسیون سبک‌تر می‌شود، پس اجرای مدل‌های کوچک روی CPU هم ممکن است.

خیر. پلن آماده سرور اختصاصی ایران وب‌داده بر پایه HPE DL360 Gen9 با دو Xeon و 64GB رم ECC است و GPU ندارد؛ این پلن برای استنتاج روی CPU و سرویس‌های جانبی AI مناسب است. برای نیاز GPU، درخواست پیکربندی سفارشی را از طریق تیکت یا تماس ثبت کنید تا بررسی شود، یا سخت‌افزار خودتان را با کولوکیشن مستقر کنید.

کوانتیزاسیون دقت ذخیره وزن‌ها را از ۱۶ بیت به ۸، ۴ یا کمتر کاهش می‌دهد؛ نتیجه، حافظه کمتر و سرعت بیشتر است، چون به گفته NVIDIA پارامترهای بیشتری در همان پهنای باند منتقل می‌شوند. در مقابل، کیفیت پاسخ ممکن است افت کند، به‌ویژه در سطوح بسیار پایین؛ پس مدل کوانتیزه را با پرسش‌های واقعی خودتان بسنجید.

برای ابزارهای سبک، مانند دستیارهای متصل به API خارجی یا مدل‌های بسیار کوچک، سرور مجازی کافی است. اما اجرای محلی مدل زبانی به رم زیاد و دسترسی کامل به هسته‌ها و پهنای باند حافظه نیاز دارد که در سرور مجازی محدودتر یا اشتراکی است. برای مدل‌های ۷ میلیارد پارامتری به بالا، سرور اختصاصی انتخاب مطمئن‌تری است.

در این حالت کولوکیشن مناسب است: سخت‌افزار متعلق به شماست و در رک دیتاسنتر با برق، خنک‌سازی و شبکه پایدار میزبانی می‌شود. پیش از ارسال، توان مصرفی کارت‌ها، ابعاد سرور و نیاز شبکه را با تیم فنی هماهنگ کنید، چون GPUهایی مانند H100 SXM تا 700W مصرف دارند.

جمع‌بندی؛ سخت‌افزار درست، شروع درست پروژه AI

در این مقاله دیدیم که سرور هوش مصنوعی فقط یک سرور با کارت گرافیک نیست؛ ترکیبی سنجیده از قدرت محاسباتی، ظرفیت و پهنای باند حافظه، ذخیره‌سازی سریع و شبکه است. مهم‌ترین تصمیم، تشخیص نوع بار کاری است: آموزش تقریباً همیشه GPU و حافظه فراوان می‌خواهد، اما استنتاج مدل‌های کوانتیزه را می‌توان روی سرور CPU با رم بالا شروع کرد.
با قاعده ساده Hugging Face، یعنی حدود ۲ گیگابایت برای هر میلیارد پارامتر در دقت ۱۶ بیتی، و با توجه به وابستگی مرحله decode به پهنای باند حافظه، می‌توانید پیش از هزینه‌کردن نیاز واقعی خود را برآورد کنید. توصیه ما این است که با یک پایلوت کوچک شروع کنید، مصرف واقعی را اندازه بگیرید و بعد درباره GPU تصمیم بگیرید.
وب‌داده با سرور اختصاصی HPE، رم ECC، دیسک NVMe، پورت 10 گیگ و تحویل آنی، بستر مناسبی برای این پایلوت فراهم می‌کند. اگر پروژه بزرگ‌تر شد، بررسی پیکربندی سفارشی از طریق تیکت یا تماس و سرویس کولوکیشن، گام‌های بعدی شما خواهند بود.
در صورتی که سوالی داشتید می‌توانید در بخش نظرات با ما در ارتباط باشید.
امیدوارم این مقاله از بلاگ وب‌داده برای شما مفید بوده باشد.
وب داده
وب داده

جدید ترین مطالب آموزشی و کاربردی را در اینجا بخوانید !
ما با بهره‌گیری از دانش روز و تجربه متخصصان حوزه فناوری، مجموعه‌ای از آموزش‌های کاربردی و مقالات تخصصی را گردآوری کرده‌ایم که هر یک، پاسخی دقیق به پرسش‌های شماست. ؛ از مفاهیم پایه تا پیچیده‌ترین تکنیک‌های حرفه‌ای. اینجا، دانش با زبانی ساده اما عمیق در اختیار شما قرار می‌گیرد.

مقاله‌ها: 153
پاسخی بگذارید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *