مانیتورینگ سرور (Server Monitoring) یعنی جمع‌آوری مداوم معیارهایی مثل مصرف CPU، رم، دیسک و شبکه، وضعیت سرویس‌ها و سلامت قطعات سخت‌افزاری، نگه داشتن تاریخچه آن‌ها و ارسال هشدار وقتی یکی از این معیارها از آستانه تعریف‌شده رد می‌شود. نمودار فقط وسیله است؛ کار اصلی این است که مشکل را پیش از کاربران ببینید و اگر رخ داد، علتش را زودتر پیدا کنید.
✅ کشف زودهنگام: پر شدن تدریجی دیسک یا افزایش خطاهای آن، اغلب روزها پیش از توقف سرویس در نمودارها پیداست.
✅ کاهش زمان قطعی: با هشدار به‌موقع، واکنش به‌جای چند ساعت در چند دقیقه انجام می‌شود.
✅ برنامه‌ریزی ظرفیت: تاریخچه مصرف نشان می‌دهد چه زمانی به رم، دیسک یا سرور بزرگ‌تر نیاز دارید.
✅ عیب‌یابی دقیق‌تر: وقتی سایت کند می‌شود، نمودارها نشان می‌دهند گلوگاه CPU است، دیسک یا شبکه.

💡 پایش سرور در دو خط

✅ سه لایه را پوشش دهید: سخت‌افزار، سیستم‌عامل و سرویس
✅ سامانه مانیتورینگ را روی سروری جدا نصب کنید تا با قطع سرور اصلی، هشدار هم قطع نشود
بدترین راه برای فهمیدن خرابی سرور، تلفن مشتری یا مدیرتان است. در این راهنما اول می‌گوییم چه چیزهایی باید پایش شوند. بعد ابزارهای سخت‌افزاری مثل iLO و SMART را کنار ابزارهای نرم‌افزاری مثل Zabbix، Prometheus و Netdata می‌گذاریم و در آخر سراغ طراحی هشدار و راه‌اندازی عملی می‌رویم 👇

🔶 سرور اختصاصی با پنل مدیریت و نمایش ترافیک

روی سرور اختصاصی ایران وب‌داده، جدا از ابزارهای مانیتورینگی که خودتان نصب می‌کنید، ترافیک مصرفی را در پنل می‌بینید و با کنسول KVM حتی هنگام قطع شبکه به سرور دسترسی دارید. برای انتخاب پیکربندی هم می‌توانید شبانه‌روز با تیم فنی مشورت کنید 👇

مانیتورینگ سرور چیست و چه چیزهایی را باید پایش کرد؟

به زبان ساده، مانیتورینگ یعنی معاینه دائمی سرور. سه نوع داده جمع می‌شود: معیارهای عددی (Metrics) مثل درصد مصرف CPU، لاگ‌ها که رویدادها را ثبت می‌کنند و بررسی‌های در دسترس بودن که از بیرون می‌سنجند سرویس پاسخ می‌دهد یا نه. کتاب SRE گوگل این دو نگاه را از هم جدا می‌کند: پایش جعبه‌سفید که بر داده‌های داخلی سیستم تکیه دارد و پایش جعبه‌سیاه که رفتار بیرونی سرویس را همان‌طور که کاربر می‌بیند می‌آزماید. معیارها و لاگ‌ها بیشتر به نگاه اول تعلق دارند و بررسی در دسترس بودن به نگاه دوم.
مانیتورینگ مثل داشبورد خودرو است. عقربه دما و سوخت وضعیت لحظه‌ای را نشان می‌دهند، چراغ هشدار وقتی روشن می‌شود که چیزی از حد مجاز گذشته باشد و دفترچه سرویس تاریخچه را نگه می‌دارد. رانندگی بدون داشبورد هم ممکن است، اما احتمالاً اولین خبرتان از مشکل، دودی است که از موتور بلند می‌شود.
[ Server A ]     [ Server B ]     [ iLO / Switch / UPS ]
  agent/exporter    agent            SNMP / Redfish
        ⬇️              ⬇️                 ⬇️
   [ Monitoring server: Zabbix or Prometheus ]
        ⬇️                              ⬇️
 [ Dashboards: Grafana ]    [ Alerts ➡️ Email / SMS / Webhook ]
در این معماری، ایجنت یا Exporter روی هر سرور معیارها را آماده می‌کند، تجهیزات شبکه و کنترلر مدیریتی سخت‌افزار از طریق SNMP یا Redfish گزارش می‌دهند و سرور مانیتورینگ همه داده‌ها را ذخیره می‌کند. داشبوردها این داده‌ها را نمایش می‌دهند و موتور هشدار، رویدادهای مهم را با ایمیل، پیامک یا Webhook می‌فرستد.

🔸 چهار سیگنال طلایی گوگل

تیم SRE گوگل در کتاب Site Reliability Engineering چهار سیگنال را برای پایش سرویس‌هایی معرفی می‌کند که مستقیم به کاربر پاسخ می‌دهند: تأخیر (Latency) یعنی زمان پاسخ به درخواست، ترافیک (Traffic) یعنی میزان تقاضا، خطاها (Errors) یعنی نرخ درخواست‌های ناموفق و اشباع (Saturation) یعنی میزان پر بودن ظرفیت سرویس. اگر فقط چند نمودار می‌توانید داشته باشید، از همین چهار شروع کنید.

سه لایه‌ای که باید پایش شوند

  • سخت‌افزار: دمای پردازنده و محیط، فن‌ها، منابع تغذیه، سلامت دیسک‌ها و کنترلر RAID و خطاهای حافظه.
  • سیستم‌عامل و منابع: مصرف CPU و Load، رم و Swap، فضای خالی و I/O دیسک، ترافیک و خطاهای کارت شبکه.
  • سرویس و کاربر: کد پاسخ HTTP و زمان پاسخ، وضعیت وب‌سرور و دیتابیس، تاریخ انقضای گواهی SSL و پاسخ‌گویی DNS.
خیلی از تیم‌ها فقط لایه دوم را پایش می‌کنند. سروری که CPU آن آرام است ممکن است یک دیسک معیوب در آرایه RAID داشته باشد یا گواهی SSL سایتش فردا منقضی شود. برای آشنایی با نقش آرایه دیسک در پایداری، مقاله RAID چیست را ببینید. اگر سرور در فضای خود سازمان نگهداری می‌شود، دما، رطوبت و نشت آب را هم مطابق راهنمای اتاق سرور استاندارد پایش کنید.

داشبورد مانیتورینگ سرور با نمودارهای CPU، رم، دیسک و شبکه که به رک سرور و اعلان هشدار متصل است

جدول معیارهای کلیدی و نشانه‌های هشدار

جدول زیر نقطه شروعی برای تعریف هشدارهاست؛ آستانه دقیق را بر اساس رفتار عادی سرور خودتان تنظیم کنید.
معیارنشانه مشکلاقدام رایج
فضای دیسکرشد پیوسته و نزدیک شدن به ظرفیت کاملپاک‌سازی لاگ، انتقال بکاپ یا افزایش فضا
سلامت دیسک (SMART)افزایش سکتورهای جابه‌جاشده یا خطای رسانهبکاپ فوری و برنامه تعویض دیسک
رم و Swapاستفاده مداوم از Swapبهینه‌سازی سرویس یا افزایش رم
CPU و Loadبار بالا و طولانی، نه جهش کوتاهبررسی پردازه‌ها و گلوگاه
شبکهافزایش ناگهانی ترافیک یا خطای پورتبررسی حمله، کابل یا پورت
سرویس وبکدهای 5xx یا زمان پاسخ بالابررسی لاگ برنامه و دیتابیس
دما و فندمای غیرعادی یا توقف فنبررسی سرمایش و قطعه

ابزارهای پایش سرور؛ iLO، Zabbix، Prometheus و Netdata

ابزارها را از پایین‌ترین لایه، یعنی سخت‌افزار، شروع می‌کنیم و تا لایه سرویس بالا می‌رویم. نسخه پایه ابزارهای نرم‌افزاری این بخش رایگان است و iLO هم همراه خود سرور ارائه می‌شود؛ هزینه اصلی، زمانی است که صرف راه‌اندازی، تنظیم هشدار و نگهداری می‌شود.

۱- سلامت سخت‌افزار با iLO و SMART

در سرورهای HPE ProLiant، iLO کنترلر مدیریتی مستقلی است که به گفته HPE خارج از سیستم‌عامل کار می‌کند و حتی وقتی سیستم‌عامل از دسترس خارج است، وضعیت سخت‌افزار را گزارش می‌دهد. نسل Gen9 از iLO 4، Gen10 از iLO 5، Gen11 از iLO 6 و Gen12 از iLO 7 استفاده می‌کند. جزئیات بیشتر را در مقاله iLO چیست نوشته‌ایم.
کنترلر iLO دما، فن‌ها، منابع تغذیه، حافظه و ذخیره‌سازی را پایش می‌کند و رویدادها را در لاگ خود نگه می‌دارد. این رویدادها را می‌توان با SNMP، ایمیل یا Syslog به سامانه مانیتورینگ فرستاد؛ البته بسته به نسخه، برخی از این قابلیت‌ها به لایسنس iLO Advanced نیاز دارند. نسل‌های جدید iLO سرویس Redfish Telemetry هم دارند و HPE در وبلاگ توسعه‌دهندگانش نشان داده که داده‌های آن را می‌توان با ابزارهای متن‌باز به داشبوردی مثل Grafana رساند.
برای دیسک‌ها، بسته متن‌باز smartmontools شامل دو ابزار smartctl و smartd است و وضعیت SMART دیسک‌های SATA، SAS و NVMe را می‌خواند. سرویس smartd دائماً اجرا می‌شود و می‌تواند با دیدن نشانه‌های خرابی ایمیل بفرستد. اگر دیسک‌ها پشت کنترلر RAID سخت‌افزاری باشند، باید نوع کنترلر را با گزینه -d به smartctl معرفی کنید یا از ابزار سازنده کنترلر کمک بگیرید.
sudo smartctl -H /dev/sda        # overall health
sudo smartctl -a /dev/nvme0      # full SMART report (NVMe)
sudo systemctl enable --now smartd

⚠️ همه خرابی‌ها با SMART پیش‌بینی نمی‌شوند

هشدار SMART نشانه جدی است، اما نبود هشدار به معنای سلامت قطعی دیسک نیست و برخی دیسک‌ها بدون نشانه قبلی از کار می‌افتند. به همین دلیل مانیتورینگ جای بکاپ را نمی‌گیرد؛ راهنمای بکاپ سرور اختصاصی و قانون 3-2-1 را هم بخوانید.

۲- Zabbix؛ پلتفرم همه‌کاره برای زیرساخت

ابزار Zabbix یک پلتفرم متن‌باز کامل است با سرور مرکزی، پایگاه داده، رابط وب و ایجنت. برای محیط عملیاتی، نسخه LTS فعلی یعنی Zabbix 7.0 LTS انتخاب مطمئن‌تری از نسخه‌های غیر LTS است؛ این نسخه ۴ ژوئن ۲۰۲۴ منتشر شد. طبق سیاست چرخه عمر Zabbix، پشتیبانی کامل این نسخه تا ۳۰ ژوئن ۲۰۲۷ و پشتیبانی محدود آن تا ۳۰ ژوئن ۲۰۲۹ ادامه دارد. انتشار نسخه 8.0 LTS طبق همین صفحه برای سه‌ماهه چهارم ۲۰۲۶ برنامه‌ریزی شده و تا زمان نگارش این مقاله هنوز منتشر نشده است.
طبق مستندات Zabbix، ایجنت نسل جدید آن یعنی Zabbix agent 2 به زبان Go نوشته شده و افزونه‌هایی برای Docker، MySQL و سرویس‌های دیگر دارد. با قالب‌های آماده (Template)، ماشه‌ها (Trigger) و اقدام‌ها (Action) می‌توانید هشدار چندمرحله‌ای بسازید؛ مثلاً اگر مشکلی در مدت مشخصی رفع نشد، پیام به نفر بعدی هم برسد. پشتیبانی Zabbix از SNMP هم آن را برای پایش سوئیچ، UPS و کنترلرهای مدیریتی مثل iLO مناسب می‌کند.

۳- Prometheus و Grafana؛ انتخاب رایج در دنیای کانتینر

ابزار Prometheus سامانه متن‌باز پایش و هشداردهی است که سال ۲۰۱۲ در SoundCloud ساخته شد و سال ۲۰۱۶، پس از Kubernetes، به‌عنوان دومین پروژه به بنیاد CNCF پیوست. این ابزار داده‌ها را به‌صورت سری زمانی با برچسب‌های کلید و مقدار ذخیره می‌کند، آن‌ها را با مدل Pull روی HTTP از هدف‌ها می‌خواند و زبان پرس‌وجوی خودش، PromQL، را دارد.
برای سرور لینوکسی، node_exporter معیارهای سیستم‌عامل را در اختیار Prometheus می‌گذارد، Alertmanager هشدارها را گروه‌بندی و مسیریابی می‌کند و Grafana داشبوردهای گرافیکی می‌سازد. مستندات Prometheus صراحتاً می‌گوید اگر به دقت صددرصدی نیاز دارید، مثلاً برای صورت‌حساب بر اساس هر درخواست، این ابزار انتخاب مناسبی نیست، چون داده‌هایی که جمع می‌کند احتمالاً به‌اندازه کافی جزئی و کامل نیستند.

۴- Netdata؛ دید لحظه‌ای روی هر سرور

طبق مستندات پروژه، Netdata معیارها را با دقت ثانیه‌ای جمع می‌کند، سرویس‌های رایج را بدون پیکربندی اولیه شناسایی می‌کند و با مدل‌های یادگیری ماشین که روی همان سرور آموزش می‌بینند، رفتار غیرعادی را علامت می‌زند. ایجنت آن با مجوز GPLv3+ منتشر می‌شود، اما رابط کاربری داشبورد آن متن‌بسته است و رایگان همراه ایجنت ارائه می‌شود. برای نصب و استفاده عملی، آموزش مانیتورینگ با Netdata و Glances را ببینید.
نقطه قوت Netdata عیب‌یابی لحظه‌ای است: وقتی سرور همین حالا کند شده، نمودارهای ثانیه‌ای آن علت را زودتر نشان می‌دهند. اگر چند سرور دارید و می‌خواهید همه را یک‌جا ببینید، باید از ساختار Parent و Child یا سرویس ابری آن استفاده کنید؛ برای قواعد هشدار پیچیده و گزارش‌گیری بلندمدت هم Zabbix یا Prometheus انعطاف بیشتری دارند.

۵- Uptime Kuma؛ پایش از بیرون سرور

ابزارهایی که روی خود سرور اجرا می‌شوند، با قطع همان سرور یا شبکه‌اش ساکت می‌مانند و ممکن است هیچ هشداری نفرستند. ابزار Uptime Kuma متن‌باز و خودمیزبان است، HTTP(s)، TCP، Ping، DNS و چند نوع دیگر را بررسی می‌کند و طبق صفحه پروژه با بیش از ۹۰ سرویس اعلان، از جمله تلگرام، ایمیل و Webhook، کار می‌کند. آن را روی سروری جدا و ترجیحاً در شبکه‌ای دیگر نصب کنید.

ابزارهای پایش سرور: داشبوردهای Zabbix، Prometheus و Netdata و پنل مدیریت سخت‌افزار، متصل به یک رک سرور

مقایسه Zabbix، Prometheus و Netdata

جدول زیر تفاوت سه ابزار اصلی را بر اساس مستندات رسمی و تجربه رایج کاربران خلاصه می‌کند.
ویژگیZabbixPrometheus و GrafanaNetdata
مدل جمع‌آوریایجنت، SNMP و روش‌های دیگرPull از طریق HTTP با Exporterایجنت روی هر سرور
دقت زمانیبر اساس بازه هر آیتمبر اساس بازه Scrapeثانیه‌ای
نقطه قوتزیرساخت متنوع و تجهیزات شبکهکانتینر و میکروسرویسعیب‌یابی لحظه‌ای
سازوکار هشدارTrigger و Action داخلیAlertmanagerهشدارهای آماده
منحنی یادگیریمتوسطبالاتر به دلیل PromQLکم

هشدار ایمیلی، پیامکی و تلگرامی؛ هشداری که نادیده گرفته نشود

داشبوردی که کسی نگاهش نمی‌کند، مشکلی را حل نمی‌کند؛ هشدار باید خودش به دست فرد درست برسد. طبق مستندات Zabbix، این ابزار از ایمیل، اسکریپت سفارشی، Webhook و پیامک پشتیبانی می‌کند. ارسال مستقیم پیامک در Zabbix به مودم GSM متصل به پورت سریال سرور نیاز دارد. راه ساده‌تر Webhook است: با آن به API سامانه‌های پیامکی یا پیام‌رسان‌ها وصل می‌شوید و برای تلگرام و Slack هم یکپارچه‌سازی آماده وجود دارد.
روی سرورهای داخل ایران، دسترسی به برخی سرویس‌های خارجی ممکن است محدود یا ناپایدار باشد. پیش از اینکه به کانالی تکیه کنید، یک پیام آزمایشی بفرستید و دست‌کم دو کانال مستقل داشته باشید؛ مثلاً ایمیل، به‌اضافه پیامک از طریق Webhook یک سامانه پیامکی داخلی.
◀️ سطح‌بندی: هشدار «اطلاع» را از «بحرانی» جدا کنید تا نیمه‌شب فقط موارد بحرانی بیدارتان کنند.
◀️ تأخیر منطقی: برای جهش‌های کوتاه هشدار ندهید؛ شرط هشدار را طوری تعریف کنید که چند دقیقه پیاپی برقرار باشد.
◀️ مسئول مشخص: هر هشدار یک مسئول و یک دستورالعمل کوتاه برای اقدام لازم دارد.
◀️ تست دوره‌ای: به‌طور منظم، مثلاً ماهی یک بار، هشدار آزمایشی بفرستید تا مطمئن شوید مسیر ارسال سالم است.

📚 توصیه کتاب SRE گوگل درباره هشدار

طبق کتاب Site Reliability Engineering گوگل، هشداری که کسی را فرا می‌خواند (Page) فقط باید برای وضعیتی باشد که فوری است، اقدامی برایش وجود دارد و کاربر همین حالا یا به‌زودی اثرش را می‌بیند. پیشنهاد کتاب این است که هشدار بر پایه نشانه‌ها (Symptoms)، یعنی آنچه کاربر حس می‌کند، تعریف شود و بررسی علت‌ها به مرحله عیب‌یابی برسد. هشدارهای زیاد و بی‌اثر تیم را خسته می‌کنند و هشدار واقعی لابه‌لای آن‌ها گم می‌شود.

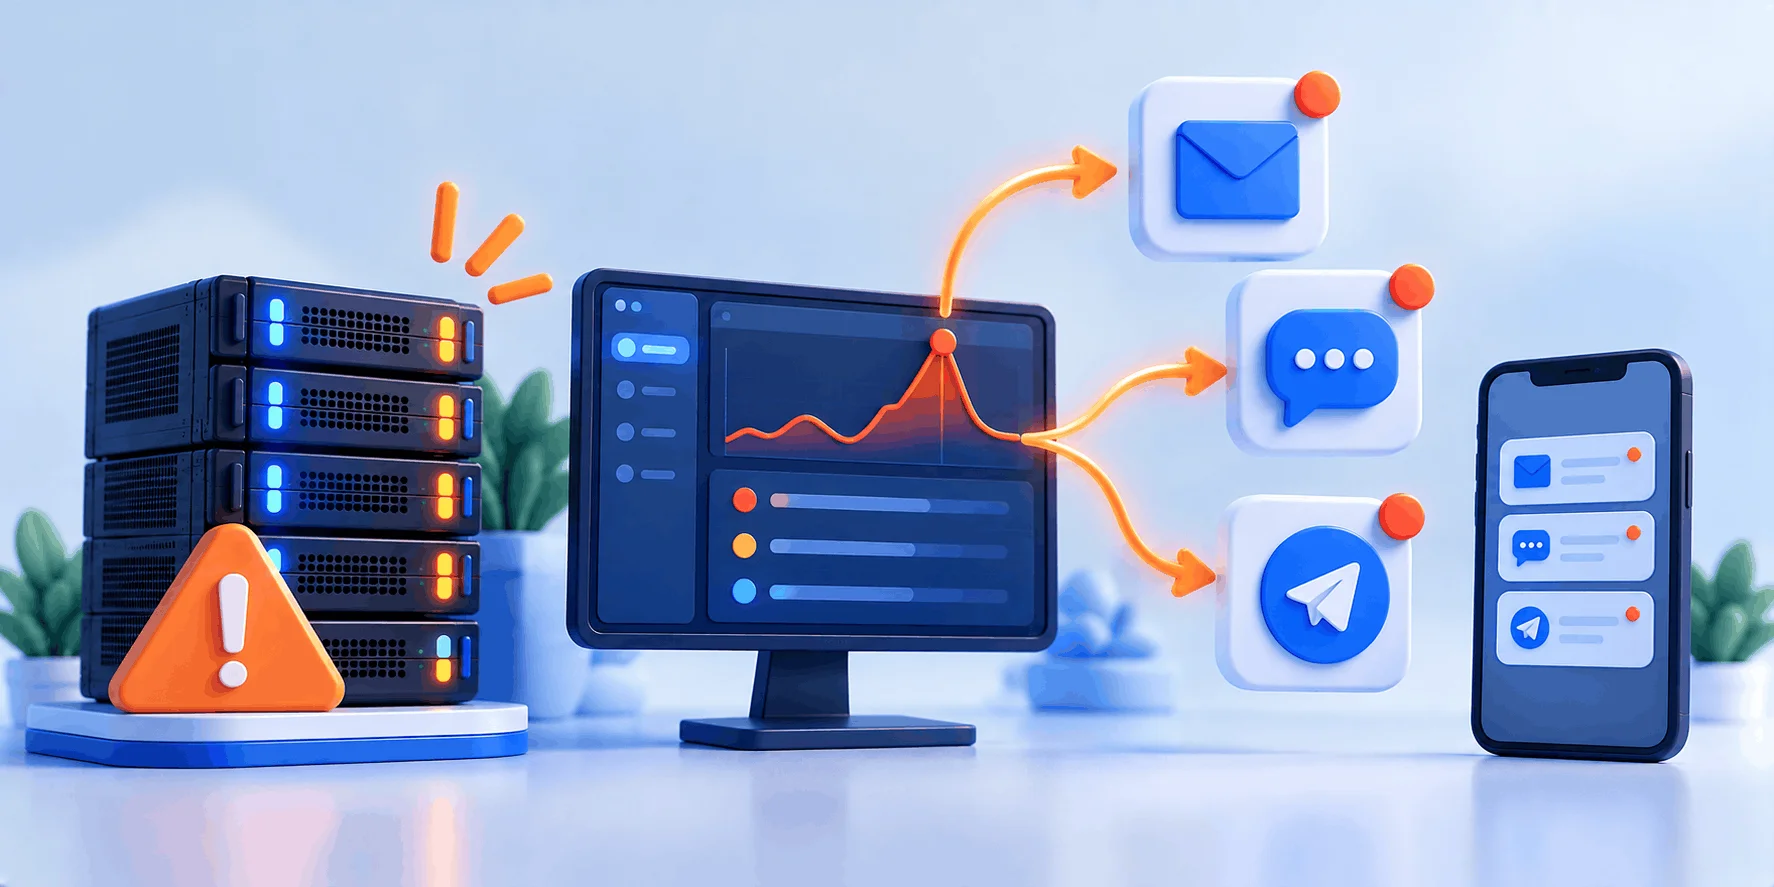
ارسال هشدار سرور پس از جهش نمودار در داشبورد، به ایمیل، پیامک و تلگرام روی گوشی

شروع عملی؛ انتخاب ابزار، معماری و خطاهای رایج

۱- ابزار را بر اساس سناریو انتخاب کنید

✅ 🎯 یک یا دو سرور و نیاز به دید سریع: Netdata به‌همراه Uptime Kuma برای پایش از بیرون.
✅ 🎯 چند سرور، سوئیچ، UPS و سخت‌افزار متنوع: Zabbix با قالب‌های آماده و SNMP.
✅ 🎯 کانتینر، Kubernetes و برنامه‌هایی با معیار سفارشی: Prometheus، Alertmanager و Grafana.

۲- سرور مانیتورینگ را از سرور اصلی جدا کنید

اگر ابزار مانیتورینگ روی همان سروری نصب باشد که قرار است پایش شود، با از کار افتادن سرور، هشدار هم از کار می‌افتد. یک ماشین کوچک جدا، مثلاً یک سرور مجازی ایران، برای میزبانی Zabbix یا Uptime Kuma در بیشتر پروژه‌های کوچک و متوسط کافی است. ظرفیت آن را بر اساس تعداد سرورها و بازه جمع‌آوری داده انتخاب کنید.

۳- امنیت خود ابزار را جدی بگیرید

داشبوردهای مانیتورینگ اطلاعات حساسی درباره زیرساختتان دارند. پنل وب را پشت فایروال یا VPN نگه دارید، از HTTPS و رمزهای قوی استفاده کنید و پورت‌های ایجنت و Exporter را فقط برای سرور مانیتورینگ باز کنید. برای اصول کلی، مقاله راهکارهای افزایش امنیت سرور را ببینید.

۴- اول خط پایه بسازید، بعد آستانه تعیین کنید

آستانه‌های پیش‌فرض برای همه سرورها مناسب نیستند. یک تا دو هفته داده جمع کنید تا رفتار عادی سرور در ساعت‌های شلوغ و خلوت روشن شود، سپس هشدارها را بر همان اساس تنظیم کنید. پس از تحویل یک سرور جدید هم بهتر است پیش از اینکه بار واقعی رویش برود، آن را با روش‌های تست سلامت و بنچمارک سرور بسنجید تا عددهای مرجع داشته باشید.
✅ مزیت مانیتورینگ خودمیزبان: داده‌ها کاملاً در اختیار خودتان است و نسخه‌های پایه هزینه لایسنس ندارند
✅ انعطاف: هشدار را می‌توانید برای برنامه‌ها و سرویس‌های خاص خودتان سفارشی کنید
❌ راه‌اندازی و نگهداری زمان‌بر است و به دانش فنی نیاز دارد.
❌ خود سرور مانیتورینگ هم باید پایش، به‌روزرسانی و بکاپ‌گیری شود.

سناریوی رایج در پشتیبانی وب‌داده

سناریویی که زیاد با آن روبه‌رو می‌شویم این است: مشتری گزارش می‌دهد سایتش هر شب در ساعت مشخصی کند می‌شود، اما در روز مشکلی ندارد. وقتی نمودارهای I/O دیسک و CPU را کنار زمان‌بندی کارهای خودکار (Cron) می‌گذاریم، معمولاً معلوم می‌شود بکاپ‌گیری یا فشرده‌سازی لاگ در همان ساعت اجرا می‌شود و دیسک را اشباع می‌کند.
راه‌حل اغلب ساده است: جابه‌جا کردن زمان بکاپ، پایین آوردن اولویت آن با nice و ionice یا نوشتن نسخه‌ها روی مقصدی جدا. بدون تاریخچه مانیتورینگ، این عیب‌یابی به حدس و آزمون و خطا تبدیل می‌شد. اگر هم مشخص شود منابع سرور مجازی فعلی کافی نیست، مقاله مهاجرت به سرور اختصاصی بدون قطعی مسیر انتقال را توضیح می‌دهد.

پایش سرور اختصاصی در وب‌داده؛ پنل، ترافیک و کنسول KVM

روی سرور اختصاصی، کنترل کامل سیستم‌عامل با شماست و می‌توانید هر ابزار مانیتورینگی را نصب کنید. در کنار آن، پنل مدیریت سرور وب‌داده چند ابزار عملیاتی در اختیارتان می‌گذارد که هنگام بروز مشکل به کار می‌آیند؛ به‌ویژه وقتی شبکه یا سیستم‌عامل پاسخ نمی‌دهد و ابزارهای داخلی هم ساکت‌اند.
✅ پنل مدیریت با ری‌استارت، روشن و خاموش کردن، کنسول KVM، نصب مجدد سیستم‌عامل و مشاهده ترافیک
✅ محاسبه ترافیک فقط بر اساس دانلود؛ آپلود رایگان است و مصرف در پنل کاربری دیده می‌شود
✅ سخت‌افزار HPE ProLiant؛ پلن آماده PRIME 9 با DL360 Gen9، دو پردازنده Xeon E5-2680 v4، 64GB رم Registered ECC DDR4 و 1TB NVMe
✅ پورت 10Gbit/s روی شبکه‌ای با آپلینک 100Gbit و محافظت DDoS با ظرفیت 100 گیگابیت بر ثانیه
✅ نصب خودکار سیستم‌عامل و تحویل آنی پس از پرداخت، مستقل از ساعت اداری
✅ بررسی پیکربندی‌های سفارشی از طریق تیکت یا تماس و مشاوره ۲۴ ساعته پیش از خرید

⚠️ پنل سرور جایگزین سامانه مانیتورینگ نیست

پنل مدیریت برای کنترل و دسترسی اضطراری طراحی شده، نه برای پایش سرویس‌ها و ارسال هشدار. راه‌اندازی Zabbix، Prometheus یا ابزار دلخواه و تعریف هشدارها بر عهده خودتان است و اگر فرصت آن را ندارید، می‌توانید از خدمات کانفیگ و مدیریت سرور کمک بگیرید. پلن آماده هم بر پایه نسل Gen9 است؛ برای نیازهای جدیدتر، پیکربندی سفارشی را از طریق تیکت یا تماس بررسی کنید.

سوالات متداول درباره ابزارها و هشدارهای پایش

مانیتورینگ سرور چه فرقی با لاگ‌گیری دارد؟

لاگ‌ها رویدادها را با جزئیات متنی ثبت می‌کنند؛ مثلاً یک خطای برنامه یا ورود ناموفق. مانیتورینگ معیارهای عددی را در طول زمان جمع می‌کند، روند را نشان می‌دهد و هنگام عبور از آستانه هشدار می‌دهد. این دو مکمل یکدیگرند: نمودار می‌گوید چه زمانی مشکل شروع شد و لاگ کمک می‌کند بفهمید چرا. در بسیاری از ابزارها، مثل Grafana همراه با Loki، می‌توانید هر دو را کنار هم ببینید.

بستگی به زیرساختتان دارد. اگر سرورهای فیزیکی، سوئیچ، UPS و تجهیزات متنوع دارید و رابط وب کامل می‌خواهید، Zabbix با قالب‌های آماده و SNMP سریع‌تر به نتیجه می‌رسد. اگر برنامه‌ها روی کانتینر و Kubernetes اجرا می‌شوند و معیار سفارشی زیادی دارید، Prometheus و Grafana انعطاف بیشتری دارند. بعضی تیم‌ها هم هر دو را کنار هم به کار می‌برند: Zabbix برای سخت‌افزار و شبکه و Prometheus برای برنامه‌ها.

برای دید لحظه‌ای و عیب‌یابی سریع روی یک یا چند سرور، Netdata انتخاب خوبی است و راه‌اندازی آسانی دارد. اما ایجنت آن روی همان سرور اجرا می‌شود؛ اگر فقط به آن تکیه کنید، با قطع سرور یا شبکه هشداری از آن نمی‌رسد. پس دست‌کم یک پایش بیرونی مانند Uptime Kuma روی سروری جدا اضافه کنید و برای مدیریت متمرکز تعداد زیادی سرور، Zabbix یا Prometheus را در نظر بگیرید.

در Zabbix از نوع رسانه Webhook استفاده کنید که برای سرویس‌هایی مثل تلگرام و Slack یکپارچه‌سازی آماده دارد و به API سامانه‌های پیامکی هم وصل می‌شود. ابزار Uptime Kuma هم از بیش از ۹۰ سرویس اعلان پشتیبانی می‌کند. روی سرورهای داخل ایران، ارسال به سرویس‌های خارجی را حتماً آزمایش کنید و یک کانال پشتیبان مانند ایمیل نگه دارید.

بله، هر ایجنت مقداری CPU، رم و فضای دیسک مصرف می‌کند و هرچه بازه جمع‌آوری کوتاه‌تر و تعداد معیارها بیشتر باشد، سربار بیشتر است. روی سرورهای امروزی این سربار معمولاً در برابر فایده آن ناچیز است، اما بهتر است پس از نصب، مصرف خود ایجنت را هم اندازه بگیرید و معیارهای غیرضروری را غیرفعال کنید.

در لینوکس با نصب smartmontools، دستور smartctl -H وضعیت کلی و smartctl -a گزارش کامل SMART هر دیسک را نشان می‌دهد. سرویس smartd را فعال کنید تا بررسی‌ها خودکار انجام شوند و هشدار با ایمیل برسد. اگر دیسک‌ها پشت کنترلر RAID سخت‌افزاری هستند، smartctl را با گزینه -d و نوع کنترلر اجرا کنید یا از ابزار سازنده کنترلر و هشدارهای iLO کمک بگیرید. با همه این‌ها، SMART جای بکاپ منظم را نمی‌گیرد.

در پنل مدیریت، ترافیک مصرفی را می‌بینید و با ری‌استارت، روشن و خاموش کردن، کنسول KVM و نصب مجدد سیستم‌عامل، کنترل اضطراری دارید. پایش سرویس‌ها و هشدارها را باید با ابزارهایی مانند Zabbix یا Netdata خودتان راه‌اندازی کنید. اگر برای پیکربندی آن کمک لازم دارید، خدمات کانفیگ و مشاوره پیش از خرید در دسترس است.

جمع‌بندی؛ از نمودار تا هشدار قابل اقدام

مانیتورینگ سرور وقتی ارزش دارد که هر سه لایه سخت‌افزار، سیستم‌عامل و سرویس را ببیند و هشدارهایش به دست فرد درست برسد. از ابزارهایی که مرور کردیم، iLO و smartmontools سلامت قطعات را گزارش می‌دهند. Zabbix برای زیرساخت متنوع مناسب است، Prometheus و Grafana برای محیط‌های کانتینری و Netdata برای دید لحظه‌ای؛ Uptime Kuma هم از بیرون در دسترس بودن سرویس را می‌سنجد.
برای شروع، با یک ابزار ساده کار را آغاز کنید، سرور مانیتورینگ را جدا نگه دارید، پیش از تعیین آستانه خط پایه بسازید و فقط برای وضعیت‌های فوری و قابل اقدام هشدار بدهید. مانیتورینگ جای بکاپ را نمی‌گیرد، اما بیشتر مشکلات را پیش از آنکه به قطعی برسند نشان می‌دهد.
اگر سروری می‌خواهید که کنترل کاملش با خودتان باشد، سرور اختصاصی وب‌داده پنل مدیریت، کنسول KVM، نمایش ترافیک، محافظت DDoS و مشاوره ۲۴ ساعته تیم فنی دارد و هر ابزاری را که در این مقاله معرفی شد، می‌توانید رویش راه بیندازید.
اگر درباره راه‌اندازی مانیتورینگ یا انتخاب ابزار سوالی دارید، در بخش نظرات بپرسید؛ تیم فنی وب‌داده پاسخ می‌دهد.
وب داده
وب داده

جدید ترین مطالب آموزشی و کاربردی را در اینجا بخوانید !
ما با بهره‌گیری از دانش روز و تجربه متخصصان حوزه فناوری، مجموعه‌ای از آموزش‌های کاربردی و مقالات تخصصی را گردآوری کرده‌ایم که هر یک، پاسخی دقیق به پرسش‌های شماست. ؛ از مفاهیم پایه تا پیچیده‌ترین تکنیک‌های حرفه‌ای. اینجا، دانش با زبانی ساده اما عمیق در اختیار شما قرار می‌گیرد.

مقاله‌ها: 259
پاسخی بگذارید

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *